---
title: "Generales 2026, todo bayesiano (I): el voto"
date: '2026-10-20'
date-modified: today
draft: false
categories:
- "2026"
- encuestas electorales
- análisis bayesiano
- stan
description: 'Bayesiano a tope. Intentando capturar la incertidumbre'
lang: es
execute:
message: false
warning: false
echo: true
format:
html:
fig-height: 5
fig-dpi: 300
fig-width: 8.88
fig-align: center
code-fold: true
code-summary: "Ver el código"
code-tools: true
lightbox: true
knitr:
opts_chunk:
out.width: 80%
fig.showtext: TRUE
collapse: true
comment: "#>"
---
```{r}
#| label: setup
library(tidyverse)

dir_fb <- here::here("2026/10/full-bayesian")
leer <- \(f) read_csv(file.path(dir_fb, f), show_col_types = FALSE)
num_es <- function(x, d = 1) {
  format(round(x, d), decimal.mark = ",", trim = TRUE)
}
pct_es <- function(p, d = 0) paste0(num_es(100 * p, d), " %")

# resultado del modelo conjunto (12_ajustar_conjunto.R), del pipeline de
# octubre (05_comparar.R, versión "actual"), de la ablación del error
# (16_ablacion_error.R) y de la sensibilidad de la Omega
# (17_sensibilidad_omega.R), los cuatro con el escenario mapa
may_cj <- leer("conjunto_mayorias.csv")
esc_cj <- leer("conjunto_escanos.csv")
may_oct <- leer("comparar_mayorias.csv") |> filter(version == "actual")
esc_oct <- leer("comparar_escanos.csv") |> filter(version == "actual")
esc_sin <- leer("conjunto_sin_error.csv")
may_om <- leer("sensibilidad_omega_mayorias.csv")

p_cj <- may_cj$prob[may_cj$escenario == "PP + VOX >= 176"]
p_oct <- may_oct$p_pp_vox_176
pp_cj <- esc_cj |> filter(partido == "PP")
pp_oct <- esc_oct |> filter(partido == "PP")
pp_sin <- esc_sin |> filter(partido == "PP")
p_om_vox <- may_om$p_pp_vox_176[may_om$variante == "vox_pp_05"]
```
## Por qué otro modelo
En el post del [metaanálisis](meta-analisis-generales-jlcr.html) hice una aproximación bayesiana a como agregar encuestas.
En ese post se hacía en dos pasos, un modelo para estimar el % de voto a los partidos principales y otro modelo complementario
para los partidos regionales. Pero se quedaba un poco cojo, había decisiones tomadas a ojo, como el sesgo histórico del PSOE.
Pero el espiritu de un modelo bayesiano es incluir las distintas fuentes de incertidumbre que pensemos que afectan al voto. Uno podría pensar en la volatilidad de las encuestas antes de las elecciones, en el error histórico de las casas, en el error conjunto que hayan tenido, en si cuando fallan a la vez en un partido aciertan en otro. En fin, multitud de cosas. En bayesiano uno también piensa en aprovechar toda la info disponible, como ya mismo en un post [lujuria e intervención](2024/03/lujuria_e_intervencion.html) y se puede condicionar incluso por colliders, a pesar de lo que diga el bueno de Judea.
Así que, por qué no aprovechar la info que tenemos de elecciones generales anteriores e incluso de autonómicas, y meter también incluso los resultados reales que se dieron en el pasado..
Pongo aquí alguna de las diferencias respecto al primer post.
| Pieza | post inicial de meta análisis | Aquí |
|---|---|---|
| Cuánto se mueve el voto hasta el día E | Tendencia lineal, extrapolada | Paseo aleatorio, con la volatilidad aprendida de seis campañas |
| Cuánto suelen fallar las encuestas | Desviaciones medidas en cinco generales, tratadas como conocidas | Estimado, con su propia incertidumbre |
| Sesgo del PSOE | +1,32 puntos, encogido a la mitad "a ojo" | Estimado con pooling |
| Correlación del error PP–Vox | +0,92 encogido a +0,5 "a ojo" | Aprendida de 44 elecciones |
| Error del bloque de partidos regionales | 1,5 puntos, un supuesto | Sin error propio: absorbe en proporción el ajuste de los grandes (supuesto declarado) |
Así que lo ponemos todo junto **en un único modelo bayesiano**:
* Las encuestas de las seis campañas generales desde 2015
* Los resultados de las cinco que ya se votaron
* Lo que han fallado las encuestas en 39 elecciones autonómicas.
Todo se estima a la vez, y cada trozo de la incertidumbre final sale de un dato o de un prior que se puede discutir.
Y como no podía ser de otra forma, sale lo mismo que en el primer post, jajaj, aquí no hay magia.
La media apenas se mueve (el PP en `r pp_cj$mediana` escaños frente a `r pp_oct$mediana`), pero la horquilla
del PP pasa de `r round(pp_oct$q05)`–`r round(pp_oct$q95)` a `r round(pp_cj$q05)`–`r round(pp_cj$q95)`
y la probabilidad de mayoría de PP y Vox baja al `r pct_es(p_cj)`.
```{r}
#| label: fig-resultados
#| fig-cap: "Escaños el 29-N con el modelo conjunto y con el pipeline de octubre, los dos con el mapa de listas a 26 de octubre (mediana e intervalo del 90 %)."
#| fig-height: 4
nombres <- c(
  PP = "PP",
  PSOE = "PSOE",
  VOX = "Vox",
  SUMAR = "Frente Amplio (Sumar)",
  ERC = "ERC",
  AA = "Adelante Andalucía",
  PODEMOS = "Podemos"
)
bind_rows(
  esc_cj |> mutate(version = "Todo bayesiano"),
  esc_oct |> mutate(version = "Pipeline de octubre")
) |>
  filter(partido %in% names(nombres)) |>
  mutate(
    partido = factor(nombres[partido], rev(nombres)),
    version = factor(version, c("Pipeline de octubre", "Todo bayesiano"))
  ) |>
  ggplot(aes(x = mediana, y = partido, colour = version)) +
  geom_pointrange(
    aes(xmin = q05, xmax = q95),
    position = position_dodge(width = 0.6)
  ) +
  scale_colour_manual(values = c("grey60", "#b8742a")) +
  labs(x = "Escaños", y = NULL, colour = NULL) +
  theme_minimal(base_size = 12) +
  theme(legend.position = "top")
```
Lo ancho de las horquillas sale del modelo. En cada `draw` de la posterior tenemos tanto el voto latente (como la agregación de las encuestas) en el día E de la elección, pero gracias a que sabemos el resultado real en elecciones anteriores hemos podido estimar una distribución de cuánto se equivocan las encuestas para cada partido. Si, ya sé que unas veces se habrán equivocado más a favor de uno o de otro, pero eso es lo que hacemos en bayesiano, sabemos que eso ha pasado en el pasado, cuantificamos cuánto y lo añadimos a nuestras estimaciones. Básicamente es reconocer los límites de hasta donde puede llegar el modelo, y en vez de esconder esa incertidumbre bajo una apariencia de exactitud, la modelamos expresamente.
Y luego para llevar a escaños podemos llevar solo el voto latente (sin ese error que sabemos que ha existido) o también añadir el error y aplicarle luego toda la capa de asignación de escaños que ya hemos contado en post anteriores.
```{r}
#| label: tbl-ablacion
knitr::kable(
  bind_rows(
    pp_sin |> mutate(Versión = "Todo bayesiano, solo el voto latente"),
    pp_cj |> mutate(Versión = "Todo bayesiano, con el error estimado"),
    pp_oct |> mutate(Versión = "Pipeline de primer post (error fijado a mano)")
  ) |>
    transmute(
      Versión,
      Mediana = mediana,
      `IC90` = paste0(round(q05), "–", round(q95)),
      `Ancho del IC90` = round(q95 - q05)
    ),
  align = "lrrr"
)
```
La horquilla más estrecha corresponde a la que sale de proyectar escaños usando solo el voto latente, luego la que usamos en los posts anteriores, donde añadimos un error a ojo, y el intervalo más ancho es el del modelo bayesiano completo, donde se estima también la distribución del error histórico
Cuando uno ve un intervalo tan ancho, lo primero que uno piensa, es "este tipo no se quiere mojar", y en muchos casos es así.
Aquí sin embargo va más por poner sobre la mesa toda la incertidumbre que hay, no trabajo para un periódico, no tengo la presión de acertar o no, ni de dar horquillas mega estrechas jugandome el prestigio. Pongo lo que sale tras modelar, como he podido, las fuentes de incertidumbre. ¿Mejorable? Fijo.
Con un IC al 90% uno pensaría que estaría bien que, al repetir 100 veces las elecciones, el verdadero valor del voto estuviera en alrededor de 90 de los 100 intervalos que construimos. Esa es la idea frecuentista de cobertura, la del procedimiento repetido muchas veces. El intervalo que da el modelo es otra cosa: un 90% predictivo bayesiano dice que, dados el modelo y los datos, la probabilidad de que el resultado del 29-N caiga dentro es del 90%. No se puede repetir la elección 100 veces, pero sí que puedo hacer un viaje al pasado y comprobar la cobertura empírica: comparar como habrían quedado los intervalos si hubiera hecho el mismo procedimiento para elecciones pasadas. Eso lo pongo al final del post.
::: {.callout-note collapse="true"}
## Qué entiendo aquí por "todo bayesiano"
Que todo lo que va de las encuestas al voto nacional es **un solo
posterior**: no hay trozos ajustados por separado ni capas puestas a mano
entre medias. Lo que se queda fuera del full bayesian.
- El paso de votos a escaños (reparto provincial, umbral y D'Hondt), es una "maquinaria" que toma como input la posterior del voto latente o la del voto latente con error, pero a nivel nacional. La proyección a escaños a nivel de provincia es una metodología ad hoc que ya he explicado, hay otras, por supuesto. Lo bueno, que la incertidumbre de la posterior del voto se propaga en cada simulación. Es lo que se hace en lo que se conoce como *bayesian decision theory*
- Algunos supuestos explícitos que no se me ha ocurrido como meterlo todo en el bayesiano. Como la transferencia del voto podemos en Cataluña, la renuncia del Frente Amplio en Teruel (su voto se reparte entre el PSOE y fuera), el punto de partida de Adelante Andalucía o el tamaño de las encuestas antiguas que no lo publicaban. En esos casos, al menos utilizo una priori plausible pero sin verosimilitud.
:::
Esto va en dos posts. Este es el del **voto**: cómo se estima y cuánto puede
fallar. El siguiente, el de cómo ese voto se convierte en **escaños**.
```{r}
#| label: datos-modelo
# tamaño de los datos del modelo conjunto (11_datos_conjunto.R)
source(here::here("2026/10/full-bayesian/11_datos_conjunto.R"))
dc <- datos_conjunto()
n_camp <- tibble(
campana = dc$campanas,
encuestas = as.integer(table(factor(dc$enc_campana, seq_len(dc$C))))
)
n_2026_grandes <- sum(str_detect(dc$encuestas$encuesta, "^2026-(g|ag)"))
n_2026_desglose <- sum(str_detect(dc$encuestas$encuesta, "^2026-d"))
n_pasadas <- sum(n_camp$encuestas[n_camp$campana != "2026"])
```
## Mapa conceptual, por aclararnos un poco.
La idea es sencilla :
**todas las campañas generales funcionan igual**.
Hay un voto que no vemos y que va cambiando de semana en semana. Las encuestas lo intentan medir, con su ruido y con la metodología propia de cada casa, que no conocemos.
Y el día de la votación, el resultado es el que es y las encuestas fallan o aciertan en mayor o menor medida. Para las elecciones
del 29 de Noviembre no tenemos ni zorra de si fallarán mucho o poco, pero si que podemos aprovechar lo que pasó en elecciones pasadas para calibrar en cierta forma como lo hicieron en el pasado y con la esperanza o desesperanza de que este año sea parecido (una distribución de nuevo). Al fin y al cabo eso es lo que hacemos cuando hacemos inferencia.
En resumen de las cinco generales anteriores ya conozco el resultado. De la de 2026,
todavía no. Y un solo modelo aprende de las seis a la vez:
```{mermaid}
%%| label: fig-mapa
%%| fig-cap: "El modelo conjunto: cuatro fuentes de datos, un solo posterior. En azul, los datos; en naranja, las piezas del modelo; en verde, lo que sale."
flowchart TD
  E1["Encuestas 2026<br/>grandes + desglose regional"]:::datos
  E2["Encuestas de las campañas<br/>20D, 26J, 28A, 10N y 23J"]:::datos
  C["Efecto de cada casa"]:::modelo
  V["Voto latente de cada campaña<br/>paseo aleatorio semanal"]:::modelo
  R["Resultados de<br/>esas cinco generales"]:::datos
  A["Última semana de encuestas<br/>en 39 autonómicas"]:::datos
  ER["Error del consenso el día E<br/>sesgo, tamaño y correlación"]:::modelo
  F["Voto el 29-N<br/>voto latente + error"]:::salida
  S["Escaños<br/>(segunda parte)"]:::salida
  E1 --> V
  E2 --> V
  C --> V
  V --> ER
  R --> ER
  A --> ER
  ER --> F
  F -.-> S
  classDef datos fill:#e3eefb,stroke:#3b6ea8,color:#1a1a1a
  classDef modelo fill:#fdebd3,stroke:#b8742a,color:#1a1a1a
  classDef salida fill:#e2f2e3,stroke:#3f8a46,color:#1a1a1a
```
Las piezas de en medio son las que voy a ir contando una a una:
1. **El voto latente.** Lo que diría la media de las casas cada semana (si hicieran encuestas cada semana). Se
mueve poco a poco, y cuánto se mueve lo aprende el modelo, campaña a
campaña.
2. **El efecto casa.** Cada encuestadora tira para su lado. Dentro de una
campaña, unas manías compensan a otras: el voto latente es la media de
las casas, no lo que diga ninguna en concreto.
3. **El error del consenso.** Aunque las casas se compensen entre sí, todas
juntas pueden meter la pata a la vez. Y eso no se ve en las encuestas:
solo se ve el día de la votación. Por eso hacen falta los resultados
pasados y las autonómicas.
Con los datos en la mano, son `r n_pasadas` encuestas de las cinco campañas
pasadas, `r n_2026_grandes` encuestas de 2026 con los grandes partidos,
`r n_2026_desglose` con el desglose de los partidos regionales y
`r dc$Ja` encuestas de la última semana en `r dc$Ea` autonómicas.
::: {.callout-tip collapse="true"}
## Ver todas las encuestas que usa el modelo
Las tablas se pueden ordenar y filtrar. En las campañas pasadas, "Otros"
lleva dentro a Cs en 2015-2019; en 2026, a los partidos regionales y al
resto. Las encuestas antiguas que no publicaban el tamaño de la muestra van
con n = 1.000, que algo hay que poner. Y el CIS y ElectoPanel no entran con
los grandes partidos.
```{r}
#| label: tablas-encuestas
#| code-summary: "Código de las tablas"
nombre_campana <- c(
`20d` = "20D-2015",
`26j` = "26J-2016",
`28a` = "28A-2019",
`10n` = "10N-2019",
`23j` = "23J-2023",
`2026` = "29N-2026"
)
# % de cada celda dentro de su encuesta (en el desglose, % del BLOQUE)
a_pct <- function(d) {
d |>
group_by(encuesta) |>
mutate(n = sum(y), pct = 100 * y / n) |>
ungroup()
}
tabla_dt <- function(d, cols_pct) {
DT::datatable(
d,
rownames = FALSE,
filter = "top",
options = list(pageLength = 10, scrollX = TRUE)
) |>
DT::formatRound(cols_pct, digits = 1, mark = ".", dec.mark = ",")
}
grandes <- bind_rows(
map_dfr(elecciones_hist, encuestas_pasadas),
encuestas_2026_grandes()
) |>
a_pct() |>
mutate(
celda = recode(
celda,
RESTO = "Otros",
BLOQUE = "Otros",
IZQ = "Sumar + Podemos",
VOX = "Vox",
SUMAR = "Sumar",
PODEMOS = "Podemos"
),
campana = nombre_campana[campana]
) |>
select(encuesta, campana, casa, fecha, n, celda, pct) |>
pivot_wider(names_from = celda, values_from = pct) |>
select(-encuesta) |>
relocate(
any_of(c("PP", "PSOE", "Vox", "Sumar", "Podemos", "SALF", "Otros")),
.after = n
) |>
arrange(desc(fecha))
desglose <- encuestas_2026_desglose() |>
a_pct() |>
mutate(celda = sub("EH_Bildu", "EH Bildu", celda)) |>
select(encuesta, casa, fecha, `n (BLOQUE)` = n, celda, pct) |>
pivot_wider(names_from = celda, values_from = pct) |>
select(-encuesta) |>
arrange(desc(fecha))
autonomicas <- read_csv(
file.path(dir_fb, "errores_autonomicas.csv"),
show_col_types = FALSE
) |>
transmute(
eleccion,
casa = norm_casa(fuente),
fecha,
`PP encuesta` = PP,
`PP real` = real_PP,
`PSOE encuesta` = PSOE,
`PSOE real` = real_PSOE,
`Vox encuesta` = VOX,
`Vox real` = real_VOX
) |>
arrange(desc(fecha))
```
::: {.panel-tabset}
### Campañas generales
```{r}
#| label: tabla-grandes
#| code-fold: true
tabla_dt(
  grandes,
  intersect(
    c("PP", "PSOE", "Vox", "Sumar", "Podemos", "SALF", "Otros"),
    names(grandes)
  )
)
```
### Desglose regional 2026
```{r}
#| label: tabla-desglose
#| code-fold: true
tabla_dt(desglose, setdiff(names(desglose), c("casa", "fecha", "n (BLOQUE)")))
```
### Autonómicas
```{r}
#| label: tabla-autonomicas
#| code-fold: true
tabla_dt(autonomicas, names(autonomicas)[-(1:3)])
```
:::
:::
### El modelo en una página
Para el que prefiera verlo todo de golpe. Parece muy complicado, pero no lo es tanto. Un modelo generativo, donde para llegar al final, que son las encuestas observadas, se modela de donde puede venir el número que dan.
Voto latente que cada encuesta tiene un sesgo y no lo ve tal cual, el como ese voto latente cambia semana a semana y las encuestas solo toman "datos" en ciertos períodos. Y luego se usa el resultado real de elecciones pasadas y comparar con el voto latente que daban las encuestas para estimar como se equivocan . Usamos las autonómicas y el resultado real en estas para estimar mejor ese error y también para ver si por ejemplo se equivocan al repartir , luego se verá que cuando sobreestiman al pp subestiman a vox y al revés.
$$
\begin{aligned}
\text{Encuestas:}\quad & \mathbf{y}_i \sim \operatorname{DirMult}\big(n_i,\ \phi_c\, \mathbf{q}_i\big),
\qquad \mathbf{q}_i = \operatorname{celdas}\!\big(\operatorname{softmax}(\boldsymbol{\theta}_{c,t_i} + \boldsymbol{\beta}_{c,h_i})\big) \\[4pt]
\text{Voto latente:}\quad & \boldsymbol{\theta}_{c,t} = \boldsymbol{\theta}_{c,t-1} + \boldsymbol{\omega}_{c,t},
\qquad \omega_{c,t,k} \sim N\!\big(0,\ \sigma_{c,g(k)}\, e^{\kappa\, \mathbb{1}[t \in \text{campaña}]}\big) \\[2pt]
& \log \sigma_{c,g} = \log \sigma_g + \tau\, z_{c,g}, \qquad z_{c,g} \sim N(0, 1) \\[4pt]
\text{Casas:}\quad & \beta_{c,h,k} \sim N\big(0,\ \sigma^{\text{casa}}_{g(k)}\big), \qquad \textstyle\sum_h \beta_{c,h,k} = 0 \\[4pt]
\text{Resultado:}\quad & \operatorname{logit}(\mathbf{r}_c) - \operatorname{logit}(\mathbf{v}_{c,T}) \sim
N\big(\boldsymbol{\mu}^{\text{gen}},\ \operatorname{diag}(\boldsymbol{\sigma}^{\text{gen}})\,\Omega\,\operatorname{diag}(\boldsymbol{\sigma}^{\text{gen}})\big),
\qquad \mathbf{v}_{c,T} = \operatorname{softmax}(\boldsymbol{\theta}_{c,T}) \\[4pt]
\text{Autonómicas:}\quad & z_{jk} \sim N\big(\mu^{\text{aut}}_k + \delta_{e,k} + b_{h,k},\ s_k\big),
\qquad \boldsymbol{\delta}_e \sim N\big(\mathbf{0},\ \operatorname{diag}(\boldsymbol{\sigma}^{\text{aut}})\,\Omega\,\operatorname{diag}(\boldsymbol{\sigma}^{\text{aut}})\big) \\[2pt]
& \boldsymbol{\sigma}^{\text{gen}} = \boldsymbol{\sigma}^{\text{aut}}\, e^{\gamma}
\end{aligned}
$$
Notación: $k$ es la familia de partido y cada campaña $c$ tiene las suyas:
en 2026 son 14 (PP, PSOE, VOX, Sumar, Podemos, SALF, más Junts, ERC, PNV,
EH Bildu, BNG, CC, UPN y el resto); en las pasadas solo se sigue a los
grandes, con la coalición de la izquierda en una sola familia (la «SUMAR» de
cada época) y todo lo no regional en RESTO. $g(k)$ es el grupo de volatilidad
al que pertenece cada familia: PP, PSOE, VOX y SUMAR cada uno por su lado,
Podemos y SALF juntos, los regionales juntos y RESTO. En la línea de las
autonómicas, $k$ recorre los cuatro grupos del error (PP, PSOE, VOX y
SUMAR), $e$ la elección autonómica y $j$ su encuesta. El resto: $c$ campaña,
$t$ semana, $h$ casa, $i$ encuesta.
Y en cristiano, línea a línea:
- **Encuestas.** La encuesta $i$, de la casa $h$, en la semana $t$ de la
campaña $c$, cuenta votos por celdas. Cada celda suma una o varias
familias de partidos (en 2026, la celda "otros" suma los regionales). La
Dirichlet-multinomial deja que las encuestas varíen más de lo que da el
puro muestreo; cuánto, lo dice $\phi_c$ (si es muy grande, nada más que
el muestreo).
Las encuestas con desglose regional entran **condicionadas** al total de
"otros" de esa encuesta: solo cuentan cómo se reparte ese total. Muchas
son las mismas encuestas que dan los grandes partidos, pero no se cuentan
dos veces: la probabilidad de una encuesta multinomial se descompone
exactamente en la de los grandes con el total de "otros" por un lado y la
del reparto de "otros" por otro.
- **Voto latente.** $\boldsymbol{\theta}_{c,t}$ es lo que diría la media de
las casas esa semana, en la escala de la softmax. Cambia cada semana un
paso al azar. El tamaño del paso depende del grupo de partidos $g$ y de la
campaña: cada campaña tiene su volatilidad, parecida a la de las demás pero
no igual ($\tau$ mide cuánto difieren). $\kappa$ dice si el voto se mueve
más en las ocho últimas semanas.
- **Casas.** Cada casa tira hacia su lado ($\beta$), y dentro de cada
campaña los efectos suman cero: el voto latente es la media de las casas.
- **Resultado.** En las generales pasadas conocemos el resultado
$\mathbf{r}_c$. Lo que se separa del voto latente del día E, en logit, es
el error del consenso: un sesgo $\boldsymbol{\mu}$, un tamaño
$\boldsymbol{\sigma}$ por partido y una correlación $\Omega$ entre
partidos. Para 2026 ese error no se observa: se sortea de la misma normal.
- **Autonómicas.** Aportan el error de 217 encuestas de la última semana en
39 elecciones: su propio sesgo, un error común a cada elección
($\boldsymbol{\delta}_e$) y un sesgo por casa ($b$). Comparten con las
generales la correlación $\Omega$ y el patrón de los tamaños, con un nivel
propio ($\gamma$).
### Las celdas
Ninguna encuesta entra al modelo partido a partido: entra en **celdas**, que
son agrupaciones de familias. Y la verosimilitud se escribe sobre lo que la
fuente publicó, ni más ni menos.
Un ejemplo real, que es el que motivó esto. La última Sigma Dos (El Mundo,
campo del 1 al 14 de octubre, n = 3.007) no separa a SALF ni a los
regionales: publica PP, PSOE, VOX y "Frente Amplio + Podemos" juntos.
Pasa con más encuestas, las opciones que barajaba eran excluir esas encuestas, o asumir cierto reparto. Pero en el modelo bayesiano en Stan se puede hacer otra cosa, meter cada encuesta con la info que aporta.
| Celda | Lo publicado | Familias del modelo que agrupa |
|---|---|---|
| PP | 31,5 % | PP |
| PSOE | 25,3 % | PSOE |
| VOX | 19,5 % | VOX |
| Izquierda fuera del PSOE | 10,9 % | Sumar + Podemos |
| Resto | 12,8 % | SALF + los 7 regionales + otros |
El multinomial sobre esas celdas hace dos cosas a la vez: exige que la suma
cuadre con lo publicado y es indiferente al reparto interior mientras la
suma cuadre.
El reparto se decide en base a lo que aportan otras encuestas. Si varias encuestas tienen la info separada de Sumar y Podemos se aprovecha eso, si otras lo publican junto también se aprovecha esa info. En el primer caso sirve para ver como se reparte y el segundo aporta información de la verosimilitud de la suma de ambos partidos.
No hay ninguna línea de código que "rellene" el interior de la celda: es la definición
misma de la distribución posterior. Lo mismo que ya pasaba con el desglose
regional, que entra condicional al total del BLOQUE: la verosimilitud de una
encuesta multinomial se factoriza en la de sus grupos y la condicional del
interior, y el modelo la aprovecha entera.
```{r}
#| label: ejemplo-agregada
# qué lleva el modelo en la semana de la encuesta de Sigma Dos, a los dos
# bloques que la encuesta publica
semana_ag <- floor(as.numeric(as.Date("2026-10-14") - inicio_2026) / 7) + 1
bloque_ag <- leer("conjunto_tendencia.csv") |>
  filter(semana == semana_ag) |>
  mutate(
    bloque = case_when(
      partido %in% c("SUMAR", "PODEMOS") ~ "izquierda fuera del PSOE",
      partido %in% c("SALF", fams_bloque_cj, "RESTO") ~ "resto"
    )
  ) |>
  group_by(bloque) |>
  summarise(mediana = sum(mediana), .groups = "drop") |>
  filter(!is.na(bloque))
ag_izq <- bloque_ag$mediana[bloque_ag$bloque == "izquierda fuera del PSOE"]
ag_resto <- bloque_ag$mediana[bloque_ag$bloque == "resto"]
```
Con números: en la semana de la encuesta, el modelo lleva a Sumar y Podemos
un `r num_es(ag_izq)` % juntos (Sigma Dos publicó 10,9) y a SALF, los
regionales y los otros un `r num_es(ag_resto)` % (Sigma Dos publicó 12,8).
La encuesta informa sobre las dos sumas, y no dice nada del reparto interior,
ese queda a cargo de las encuestas que sí publican cada pieza.
Hay un detalle que hace aún más natural el agregado: "Sumar + Podemos" es
exactamente el nivel de detalle con el que el modelo de error razona sobre
las elecciones anteriores, cuando fueron juntos. (las generales de 2015–2023 solo conocen a la izquierda de
entonces junta).
El voto del 29-N, simulación a simulación, es el voto latente de la última
semana de 2026 más un error sorteado, en logit, para PP, PSOE, Vox y
Sumar+Podemos. El resto de partidos se reescala para que todo sume 100.
Y lo mismo dibujado como un DAG, con la notación de los modelos gráficos:
cada flecha va de un nodo a lo que depende de él. Los círculos grises son
datos, los blancos son parámetros y los dobles se calculan a partir de sus
padres.
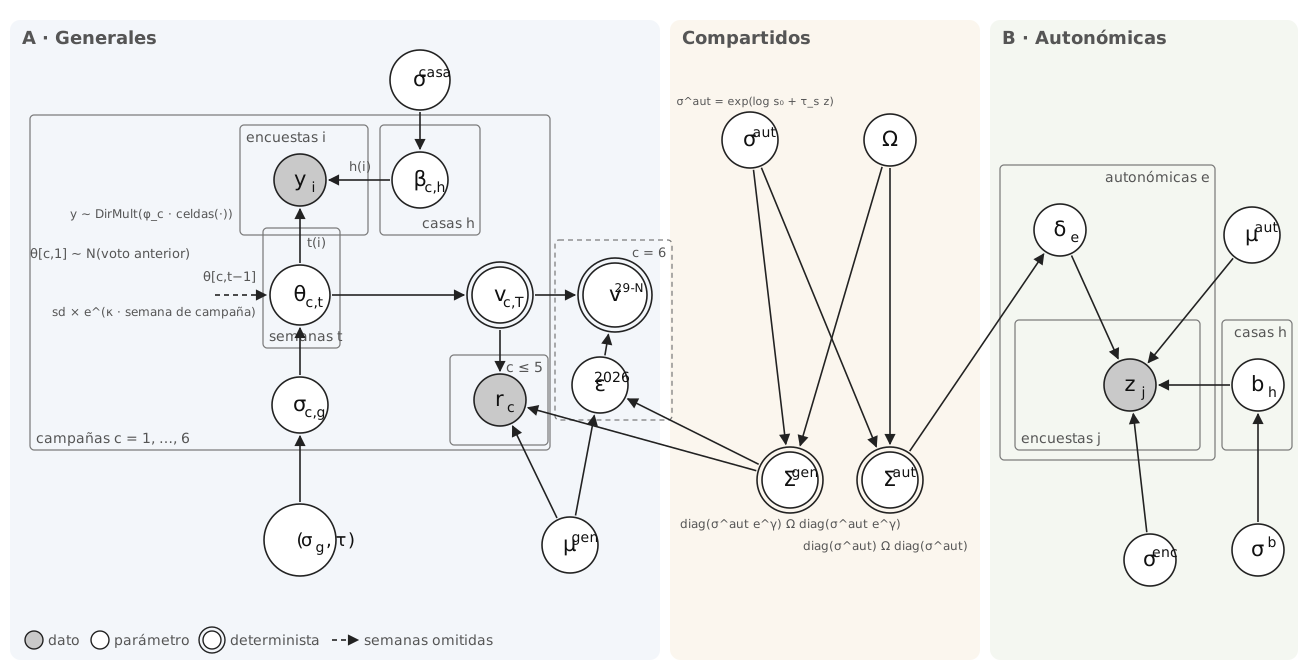{#fig-dag}
Se lee de izquierda a derecha:
- **Generales.** El voto latente $\theta_{c,t}$ es el centro: cada semana
depende de la anterior (dentro de campaña, la sd se multiplica por
$e^{\kappa \cdot \text{semana}}$) y de la volatilidad $\sigma_{c,g}$.
Las encuestas $y_i$ dependen
del voto latente de su semana y del efecto de su casa
$\boldsymbol{\beta}_{c,h}$, un vector con un componente por familia (el
ruido extra $\phi_c$ va como nota en la placa de las encuestas). El día E,
$\mathbf{v}_{c,T}$ se compara con el resultado $r_c$, que solo existe para
las cinco generales pasadas ($c \le 5$). Para 2026 ($c = 6$) el error
$\varepsilon^{2026}$ no se observa: se sortea con el mismo sesgo
$\boldsymbol{\mu}^{\text{gen}}$ y la misma covarianza $\Sigma^{\text{gen}}$.
- **Autonómicas.** El error de cada encuesta $z_j$ es la suma de un sesgo
medio $\boldsymbol{\mu}^{\text{aut}}$, el error de su elección $\delta_e$,
el sesgo de su casa $b_h$ y su ruido $\sigma^{\text{enc}}$ (el $s_k$ de las
ecuaciones de arriba).
- **Lo que comparten.** Solo $\Omega$ y las escalas
$\boldsymbol{\sigma}^{\text{aut}}$, que son independientes entre sí y con
las que se montan **dos** covarianzas: $\Sigma^{\text{gen}} =
\operatorname{diag}(\boldsymbol{\sigma}\, e^{\gamma})\,\Omega\,
\operatorname{diag}(\boldsymbol{\sigma}\, e^{\gamma})$ para las generales
y $\Sigma^{\text{aut}} = \operatorname{diag}(\boldsymbol{\sigma})\,
\Omega\, \operatorname{diag}(\boldsymbol{\sigma})$ para las autonómicas.
Ninguna de las dos es un parámetro nuevo: se calculan a partir de sus
padres y por eso van en círculo doble, cada una alimentando su tipo de
elección. Los sesgos medios no se comparten:
$\boldsymbol{\mu}^{\text{gen}}$ y $\boldsymbol{\mu}^{\text{aut}}$ van cada
uno en su panel.
Lo que une las encuestas con los resultados reales es $\mathbf{v}_{c,T}$: el
mismo voto latente que sale de las encuestas es el que se compara con lo que
se votó. Y lo que une las generales con las autonómicas son $\Omega$ y
$\boldsymbol{\sigma}^{\text{aut}}$. Por eso es un solo modelo y no varios
encadenados.
::: {.callout-note collapse="true"}
## Detalles del dibujo
- Está dibujada la versión centrada de cada nivel. En el Stan, varios van
en la parametrización no centrada (por ejemplo,
$\sigma_{c,g} = \sigma_g\, e^{\tau z_{c,g}}$), que es el mismo modelo.
- No dibujo las constantes de los priors (por ejemplo, el voto de la
general anterior, que centra $\theta_{c,1}$) ni las restricciones de suma
cero de los efectos casa.
- Para que el grafo se pueda leer, algunos objetos van como notas y no como
nodos: $\phi_c$ (nota en la placa de encuestas), $\theta_{c,1}$ y
$\kappa$ (a la izquierda de la cadena, junto al stub punteado
$\theta_{c,t-1} \to \theta_{c,t}$) y $s_0$ y $\tau_s$ (nota sobre
$\sigma^{\text{aut}}$). El $\gamma$ de las generales queda dentro de la
fórmula de $\Sigma^{\text{gen}}$.
- Es un DAG simplificado, no un traslado literal del Stan: los efectos casa
se centran dentro de cada campaña (suman cero), así que los
$\boldsymbol{\beta}_{c,h}$ de una campaña no son marginalmente
independientes entre
sí, aunque aquí se dibujen como nodos independientes. Lo que el dibujo
respeta exactamente son las dependencias: qué alimenta a qué.
- $\mathbf{v}^{\text{29-N}}$ se calcula fuera de Stan, simulación a
simulación, con el voto latente de la última semana de 2026 y
$\varepsilon^{2026}$.
- La figura sale de
[`15_dag.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/15_dag.R),
que escribe el SVG a mano.
:::
::: {.callout-note collapse="true"}
## Los priors
Todos en escala logit, centrados en valores razonables y con margen de
sobra para que manden los datos. Los priors pueden ser informativos o no, pero siempre han de ser razonables. En este caso los priors se eligen de forma que se descarten cosas imposibles pero que permita variar lo bastante para que los datos (a través de la verosimilitu actúe)
| Parámetro | Prior | En palabras |
|---|---|---|
| $\boldsymbol{\theta}_{c,1}$ | $N(\log \text{voto de la general anterior},\ 0{,}5)$ | Al empezar la campaña, el voto se parece al de la elección anterior, con mucho margen |
| $\sigma_g$ (volatilidad) | $N^+(0;\ 0{,}05)$ por semana | El voto se mueve poco de una semana a otra |
| $\tau$ | $N^+(0;\ 0{,}5)$ | Una campaña puede tener entre 0,4 y 2,3 veces la volatilidad media |
| $\kappa$ | $N(0;\ 0{,}5)$ | Sin preferencia sobre si la campaña mueve más el voto |
| $\sigma^{\text{casa}}$ | $N^+(0;\ 0{,}2)$ | Las casas difieren, pero no muchísimo |
| $\log \phi_c$ | $N(\log 2.000;\ 1{,}4)$ | Dispersión de las encuestas del orden de una muestra de 2.000 |
| $\boldsymbol{\mu}$ | $N(0;\ 0{,}1)$ | El sesgo sistemático es pequeño |
| $\boldsymbol{\sigma}^{\text{aut}}$ | escala común $\sim$ log-normal centrada en 0,1 | Errores típicos de unos 2 puntos |
| $\gamma$ | $N(0;\ 0{,}5)$ | Sin preferencia sobre si las generales fallan más o menos que las autonómicas |
| $\Omega$ | LKJ(2) | Correlaciones sin extremos |
| $\sigma^b$ (casas, autonómicas) | $N^+(0;\ 0{,}1)$ | Sesgos de casa moderados |
:::
::: {.callout-tip collapse="true"}
## El código Stan
El modelo completo está en
[`modelo_conjunto.stan`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/modelo_conjunto.stan).
Lo pego entero, para el que quiera cotillear:
```{r}
#| label: codigo-stan
#| echo: false
#| output: asis
cat(
"```stan\n",
paste(readLines(file.path(dir_fb, "modelo_conjunto.stan")), collapse = "\n"),
"\n```\n",
sep = ""
)
```
:::
## El voto latente: lo que diría la media de las casas
Cada semana hay un voto latente, que las "casas" encuestadoras medirían si se hicieran encuestas cada semana. Sería la "media" de las casas. Y he supuesto que de una semana a la siguiente cambia un poco, al
azar:
$$
\boldsymbol{\theta}_{c,t} = \boldsymbol{\theta}_{c,t-1} + \boldsymbol{\omega}_{c,t},
\qquad \omega_{c,t,k} \sim N\big(0,\ \sigma_{c,g(k)}\big)
$$
El supuesto que subyace es un **paseo aleatorio**, básicamente, es decir que para el voto latente de la semana que viene, sería como el de esta semana más un error aleatorio. La incertidumbre crece con cada semana que
pasa sin encuestas. ¿Cuánto crece? Lo deciden los datos: $\sigma$ es el
tamaño típico del paso semanal, en la escala de la softmax.
```{r}
#| label: fig-tendencia
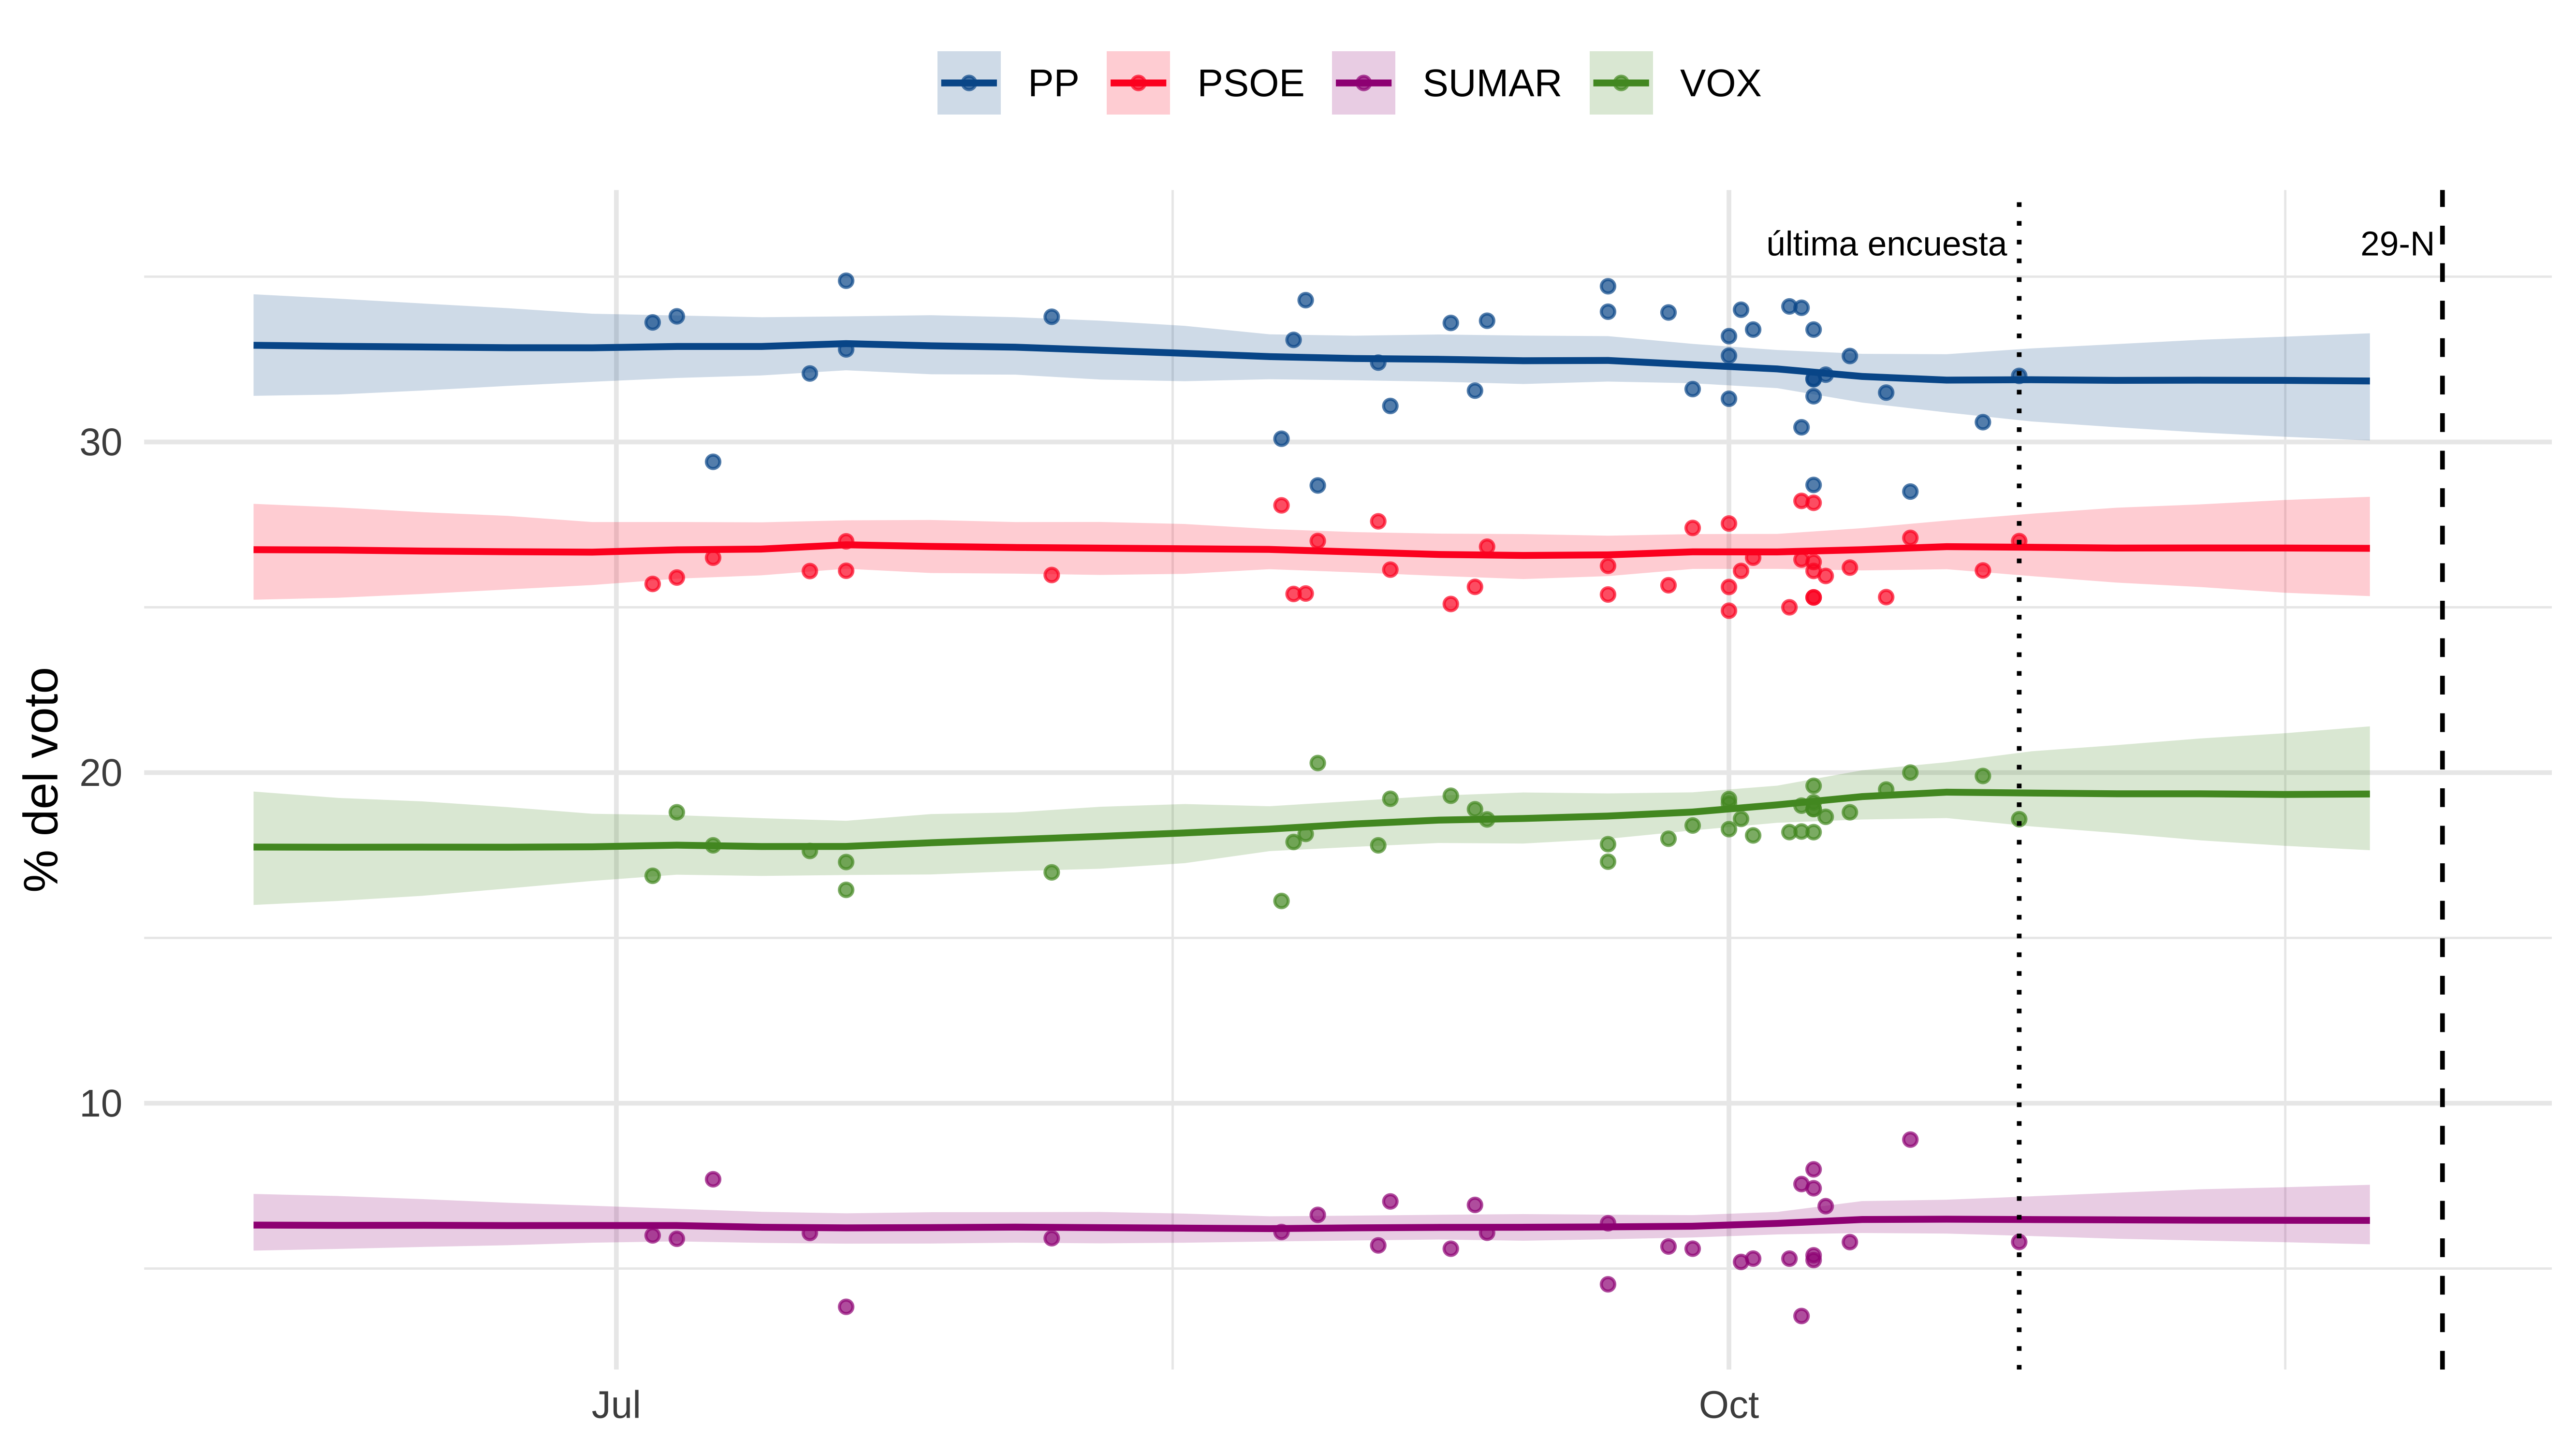
#| fig-cap: "Voto latente de los cuatro grandes en 2026 (mediana e intervalo del 90 %) y las encuestas que lo informan. Desde la última encuesta (25 de octubre) hasta el 29-N, el modelo solo puede extrapolar: el intervalo se abre."
colores <- c(
  PP = "#005999",
  PSOE = "#FF0126",
  VOX = "#51962A",
  SUMAR = "#A00B85"
)
tend <- leer("conjunto_tendencia.csv") |>
  filter(partido %in% names(colores), fecha >= as.Date("2026-06-01"))
puntos <- bind_rows(
  grandes |>
    filter(campana == "29N-2026") |>
    select(fecha, PP, PSOE, VOX = Vox, SUMAR = Sumar) |>
    pivot_longer(-fecha, names_to = "partido", values_to = "pct"),
  # las agregadas también informan al modelo y publican PP, PSOE y VOX
  # (sin Sumar ni SALF)
  encuestas_2026_agregadas() |>
    group_by(encuesta, fecha) |>
    mutate(n = sum(y)) |>
    ungroup() |>
    filter(celda %in% c("PP", "PSOE", "VOX")) |>
    transmute(fecha, partido = celda, pct = 100 * y / n)
)
ultima <- max(puntos$fecha)
sem_29n <- round(as.numeric(as.Date("2026-11-29") - ultima) / 7)
ggplot(tend, aes(fecha, mediana, colour = partido, fill = partido)) +
  geom_ribbon(aes(ymin = q05, ymax = q95), alpha = 0.2, colour = NA) +
  geom_line(linewidth = 0.8) +
  geom_point(data = puntos, aes(y = pct), size = 1.2, alpha = 0.7) +
  geom_vline(xintercept = ultima, linetype = "dotted") +
  geom_vline(xintercept = as.Date("2026-11-29"), linetype = "dashed") +
  annotate(
    "text",
    x = ultima,
    y = 36,
    label = "última encuesta",
    hjust = 1.05,
    size = 3
  ) +
  annotate(
    "text",
    x = as.Date("2026-11-29"),
    y = 36,
    label = "29-N",
    hjust = 1.1,
    size = 3
  ) +
  scale_colour_manual(values = colores, aesthetics = c("colour", "fill")) +
  labs(x = NULL, y = "% del voto", colour = NULL, fill = NULL) +
  theme_minimal(base_size = 12) +
  theme(legend.position = "top")
```
```{r}
#| label: media-casas
pp_2026 <- bind_rows(
  grandes |> filter(campana == "29N-2026") |> select(casa, fecha, PP),
  # las agregadas también cuentan en la media de las encuestas
  encuestas_2026_agregadas() |>
    group_by(encuesta, fecha) |>
    mutate(n = sum(y)) |>
    ungroup() |>
    filter(celda == "PP") |>
    transmute(casa, fecha, PP = 100 * y / n)
)
pp_media_enc <- mean(pp_2026$PP)
pp_media_casas <- pp_2026 |>
  group_by(casa) |>
  summarise(pp = mean(PP)) |>
  pull(pp) |>
  mean()
```
Si os fijáis, las encuestas del PP tienden a caer algo por encima de su
línea. No es un fallo: el voto latente es la media de las **casas**, no la de las encuestas.
```{r}
#| label: datos-volatilidad
par_cj <- leer("conjunto_parametros.csv")
vol <- par_cj |>
  filter(parametro == "sigma_rw_c") |>
  separate(partido, c("campana", "grupo"), sep = " ", extra = "merge") |>
  filter(grupo %in% c("PP", "PSOE", "VOX", "SUMAR")) |>
  # sin Vox en 2015-2016: su volatilidad ahí solo es prior
  filter(!(grupo == "VOX" & campana %in% c("20d", "26j"))) |>
  mutate(campana = factor(nombre_campana[campana], levels = nombre_campana))
v <- \(c, g, col = "mediana") {
  vol[[col]][vol$campana == nombre_campana[[c]] & vol$grupo == g]
}
tau <- par_cj |> filter(parametro == "tau_rw")
kappa <- par_cj |> filter(parametro == "kappa")
```
### No hace falta una vida media
Otra gente que hace este tipo de cosas tienen cosas como dar más peso a las encuestas recientes y que pierda su importancia conforme pasa el tiempo. Algo como "una encuesta pierde la mitad de su peso cada dos semanas". En mi aproximación no hace falta, la información de una encuesta de hace 10 semanas para llegar al voto latente de hoy ha tenido que atravesar 10 pasos del paseo aleatorio, y en cada paso pierde precisión. Y esa pérdida de precisión se estima.
En 2026 se está viendo que se pierde muy poca. El paso semanal del PP en esta campaña es de
`r num_es(v("2026", "PP"), 3)` en logit, que con el PP por el 32 % son unas
décimas de punto. La cosa apenas se ha movido desde el verano, así que el
modelo trata las encuestas de julio casi igual que las de octubre, si empiezan a salir encuestas dónde varía más las estimaciones de las encuestas, entonces el modelo estimaría una mayor incertidumbre de semana a semana.
### Cada campaña tiene su ritmo
Lo que sí cambia, y mucho, es lo que se mueve el voto de una campaña a
otra. Así que cada campaña tiene su propia $\sigma$, parecida a la de las
demás pero no igual:
$$
\log \sigma_{c,g} = \log \sigma_g + \tau\, z_{c,g}
$$
$\tau$ mide cuánto se parecen o no las campañas entre sí. Sale
`r num_es(tau$mediana, 2)` (IC90: `r num_es(tau$q05, 2)`–`r num_es(tau$q95, 2)`):
una campaña puede moverse el doble o la mitad que otra.
```{r}
#| label: fig-volatilidad
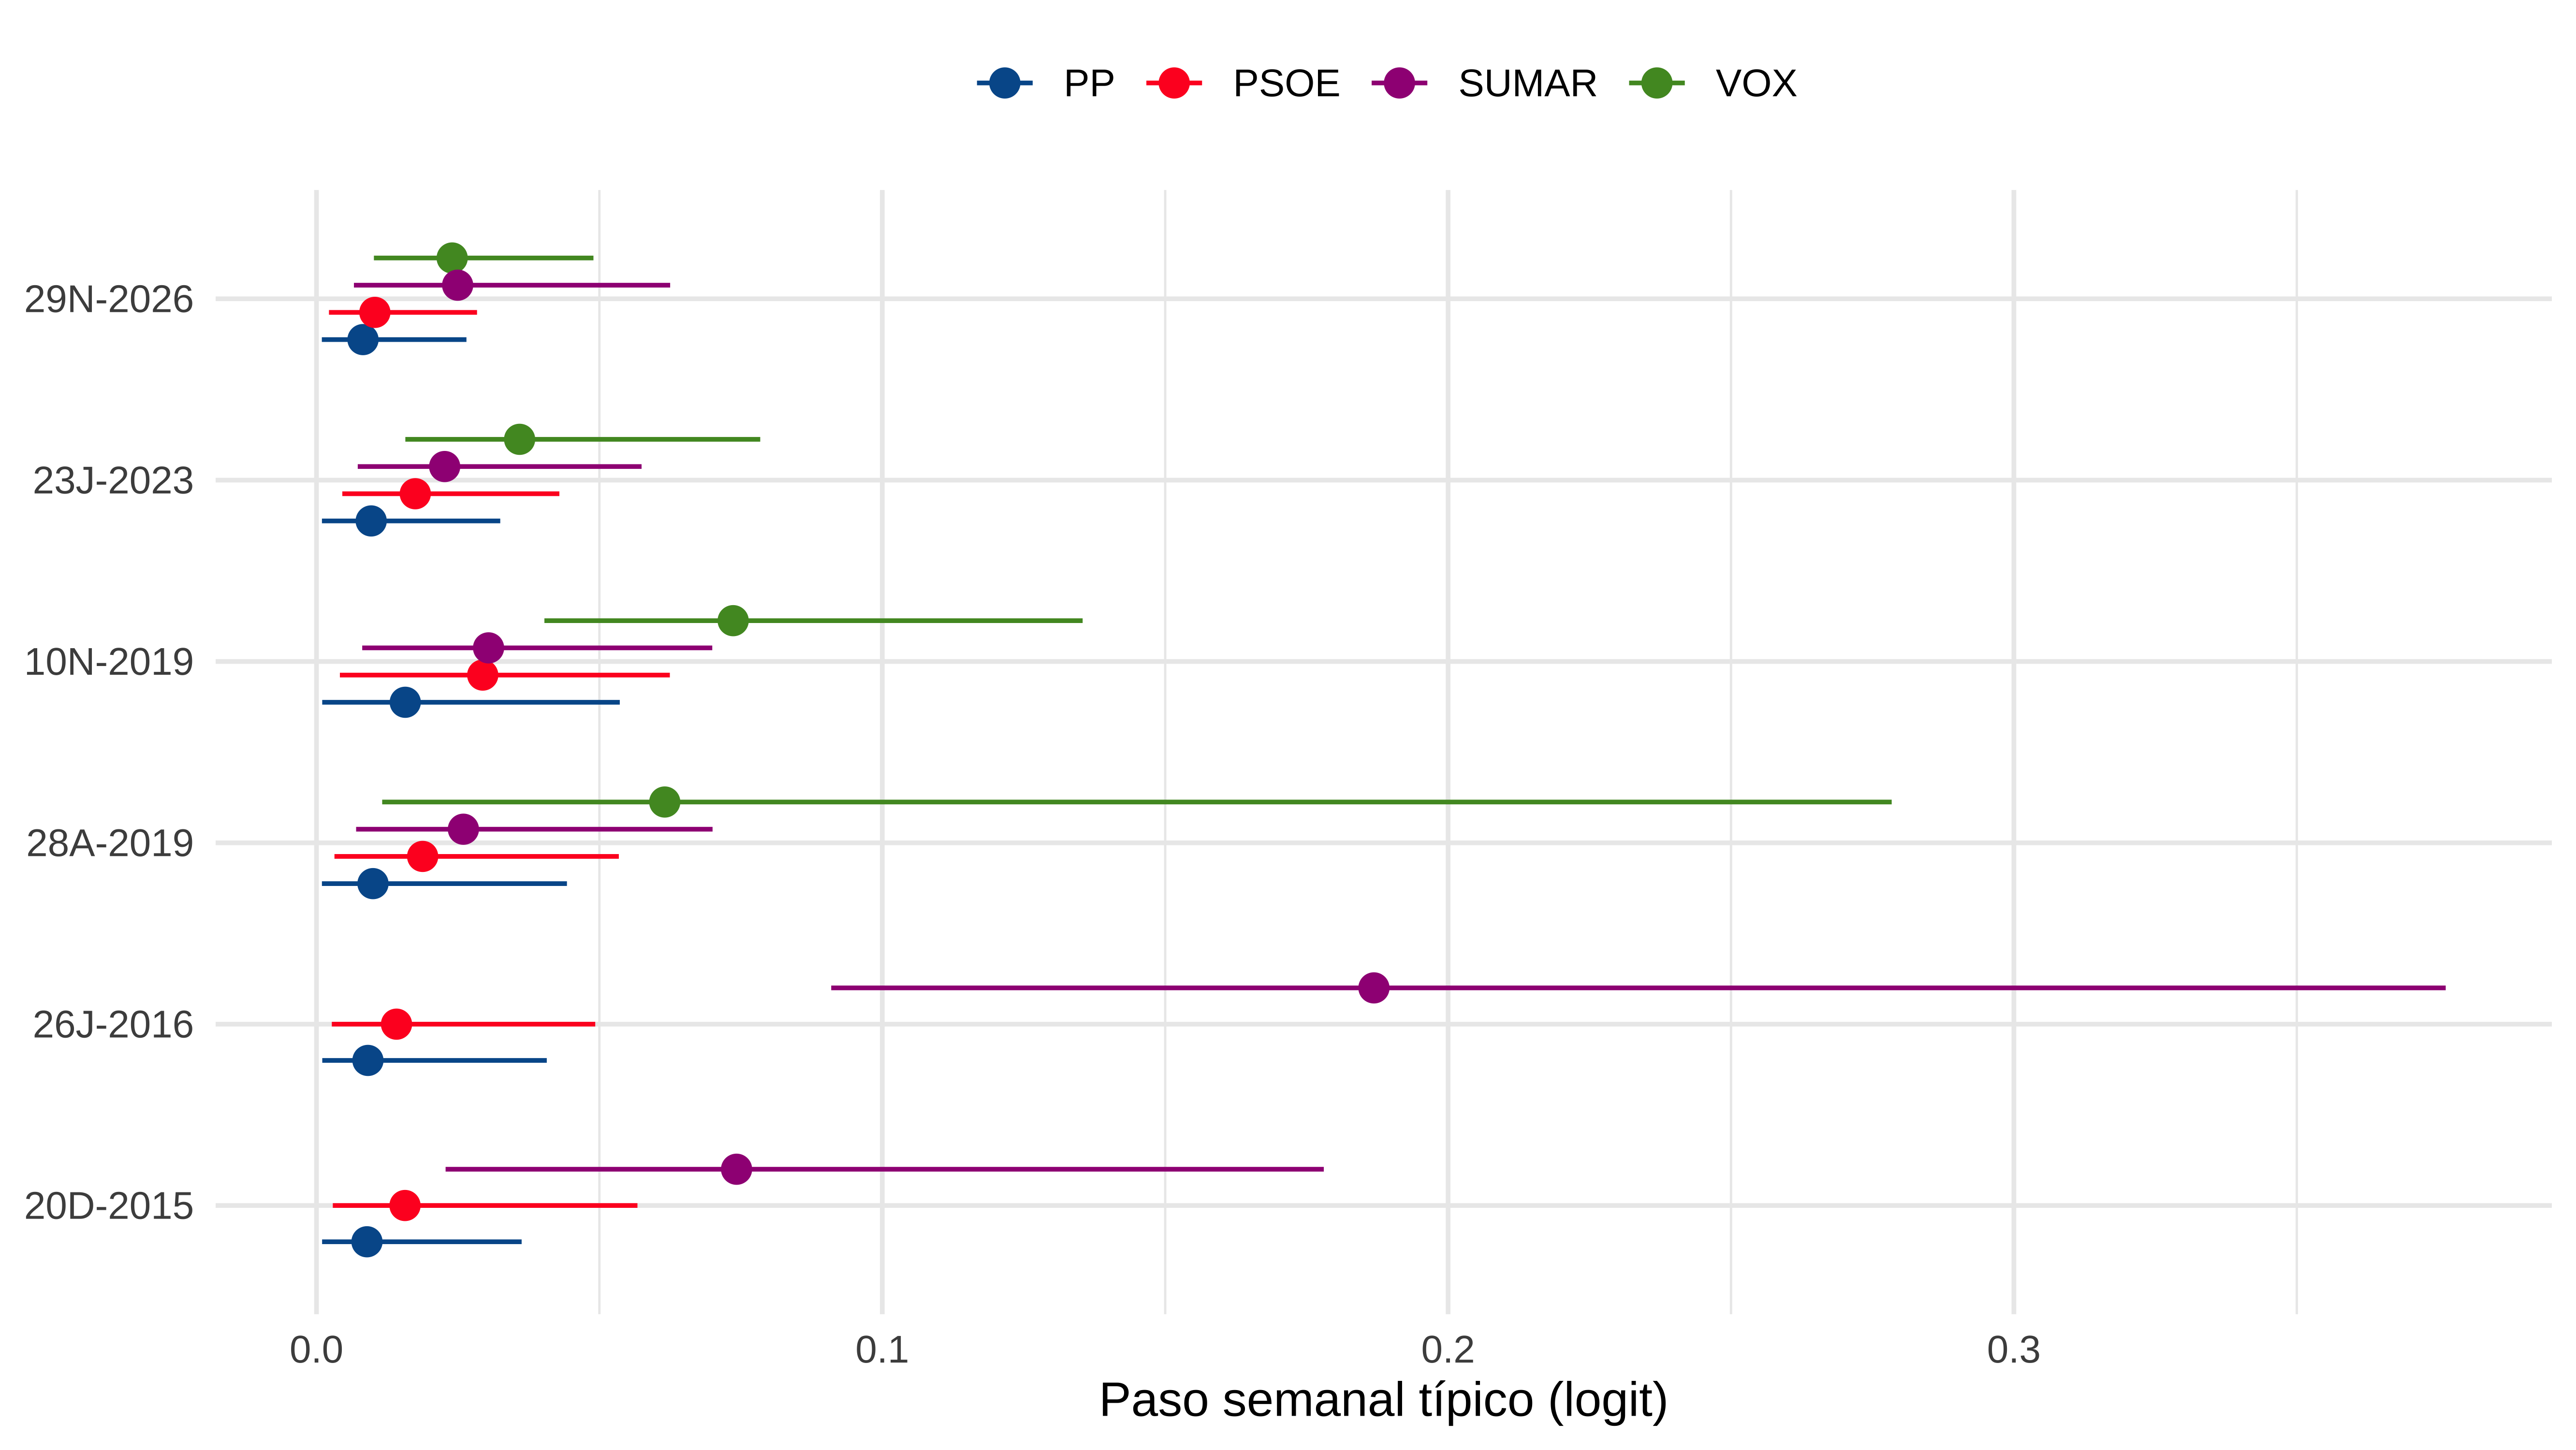
#| fig-cap: "Volatilidad semanal del voto latente en cada campaña (mediana e intervalo del 90 %, logit por semana). Sin Vox en 2015-2016, cuando no existía como partido relevante."
ggplot(vol, aes(mediana, campana, colour = grupo)) +
  geom_pointrange(
    aes(xmin = q05, xmax = q95),
    position = position_dodge(width = 0.6)
  ) +
  scale_colour_manual(values = colores) +
  labs(x = "Paso semanal típico (logit)", y = NULL, colour = NULL) +
  theme_minimal(base_size = 12) +
  theme(legend.position = "top")
```
Dos campañas destacan, y tienen su explicación: el **26J-2016**, cuando
Podemos e Izquierda Unida se unieron a mitad de precampaña (la volatilidad de
su voto, `r num_es(v("26j", "SUMAR"), 2)`, es la mayor de todas), y el
**10N-2019**, cuando Vox pasó del 10 % al 15 % del voto en seis meses
(`r num_es(v("10n", "VOX"), 3)`). La de 2026 es de las más tranquilas:
Vox `r num_es(v("2026", "VOX"), 3)` y Sumar `r num_es(v("2026", "SUMAR"), 3)`.
¿Y esto por qué importa? Porque entre la última encuesta y el 29-N quedan
`r sem_29n` semanas en las que el modelo solo puede extrapolar. Si les aplicara
la volatilidad media de todas las campañas, la incertidumbre sería aún mayor.
::: {.callout-note collapse="true"}
## ¿Y la campaña electoral en sí?
Probé también si el voto se mueve más en las ocho últimas semanas que antes
(un parámetro $\kappa$ que multiplica la volatilidad en ese tramo). Con una
volatilidad para cada campaña, sale
`r num_es(kappa$mediana, 2)` (IC90: `r num_es(kappa$q05, 2)`–`r num_es(kappa$q95, 2)`):
nada de nada. Lo que mueve el voto no es que se acerque el día de la
votación, sino lo que pasa en cada campaña. En una versión anterior, con la
misma volatilidad para todas, $\kappa$ sí salía positivo: estaba recogiendo
que algunas campañas fueron más movidas que otras.
:::
## Casas, ruido y rebaño
### Tres cosas que se mezclan
Una encuesta no se separa del voto real solo por azar. Hay tres cosas
mezcladas, y el modelo tiene que separarlas. Ejemplo tonto: tres casas, tres
semanas, % del PP.
| | Semana 1 | Semana 2 | Semana 3 |
|---|---|---|---|
| Casa A | 33 | 33 | 34 |
| Casa B | 31 | 31 | 32 |
| Casa C | 32 | **35** | 33 |
Se ven tres cosas distintas:
1. **La casa A siempre da un punto más que las otras, y la B uno menos.**
Pase lo que pase. Eso no es el voto: es la "manía" de cada casa (su
método, su universo, cómo pondera). Es el **efecto casa**.
2. **En la semana 3, las tres suben un punto a la vez.** Algo que ven todas
las casas a la vez no es manía de nadie: el voto se ha movido. Es el
**voto latente**.
3. **En la semana 2, la casa C da un 35.** Ni la C da eso otras semanas ni
las demás lo ven esa semana. Es cosa de esa encuesta suelta. Es
**ruido**.
Y esa es toda la lógica: cada cosa se distingue por lo que comparte. Lo que
se repite en la misma casa es efecto casa; lo que ven todas la misma semana
es voto; lo que no comparte nadie es ruido. El modelo hace lo mismo que
haríamos nosotros a ojo con la tabla, solo que con probabilidades en vez de
medias y teniendo en cuenta el tamaño de cada encuesta.
Para que esto funcione hace falta que varias casas publiquen en las mismas
semanas y que cada casa publique varias veces. Una casa con una sola
encuesta no deja ver su forma de hacer las cosas, y el modelo deja su efecto "casa" cerca de cero (es decir, al no saber nada de esa casa, la coloca como una casa media)
Pero hay una cosa que esta tabla **no** puede ver: que las tres casas den un
punto de más a la vez, y siempre. Para la tabla, eso es el voto. Por eso el
voto latente es la media de las casas, no la verdad. Ese error común solo se
descubre el día de la votación, y para medirlo hay que mirar al pasado.
### Las encuestas no son urnas perfectas
Si cada encuesta fuera un sorteo perfecto , sacar 1.000 bolas de una urna
con un 32 % de bolas azules, diez encuestas de la misma semana saldrían
todas a un punto y medio del valor real. Ese es el margen de error de toda
la vida, el de la **multinomial**, y es lo que usaba en los modelos de
octubre.
Pero las encuestas no son sorteos perfectos. Cada una tiene su
[cocina](https://muestrear-no-es-pecado.netlify.app/2022/01/01/cocinando/): a
quién consigue llamar esa semana, cómo pondera, qué hace con los que no
recuerdan a quién votaron…
Porque el modelo solo tiene dos formas de explicar que
las encuestas no coincidan: el azar del muestreo, que en una encuesta de
1.000 personas no da para más de un punto y medio, o que el voto se haya
movido de verdad. Si le digo que las encuestas son sorteos perfectos, todo
lo que pase de ese punto y medio lo tiene que explicar como movimiento.
Imagina tres semanas seguidas: una encuesta da al PP un 30 %, la siguiente
un 35 % y la siguiente un 31 %. Con sorteos perfectos, la única explicación
es que el PP subió cinco puntos en una semana y bajó cuatro en la
siguiente. El modelo aprende que el voto es muy nervioso, y cuando luego
tiene que proyectar `r sem_29n` semanas sin encuestas, hasta el 29-N, aplica esos
nervios y la horquilla se dispara.
La solución es la **Dirichlet-multinomial**, que es justo lo de en medio:
cada encuesta saca sus bolas de **su propia urna**, una copia algo movida de
la de verdad. Cuánto se mueven las copias lo dice un parámetro, $\phi$: con
$\phi = 200$ se mueven bastante; con $\phi$ muy grande, las copias son
iguales que la urna buena y volvemos al sorteo perfecto.
```{r}
#| label: datos-phi
phi <- par_cj |>
  filter(parametro == "log_phi") |>
  mutate(across(c(mediana, q05, q95), exp), campana = nombre_campana[partido])
phi_c <- \(c) phi$mediana[phi$partido == c]
```
$\phi$ no lo pongo yo: lo estima el modelo. ¿Cómo? Mirando
cuánto se separan las encuestas del voto latente y comparándolo con lo que
daría el sorteo puro, que se sabe porque conocemos el tamaño de cada
encuesta. Si se separan lo justo, $\phi$ sale muy grande. Si se separan
mucho más, sale pequeño. Y no lo confunde con los cambios del voto por lo
de la tabla de juguete: un cambio de verdad lo ven todas las casas a la vez;
el ruido es cosa de una encuesta suelta, que a la semana siguiente vuelve a
su sitio.
Y sale esto: en 2015, 2016 y abril de 2019 las encuestas iban cada una por
su lado ($\phi$ entre `r num_es(min(phi_c("20d"), phi_c("26j"), phi_c("28a")), 0)` y
`r num_es(max(phi_c("20d"), phi_c("26j"), phi_c("28a")), 0)`). Desde
noviembre de 2019, nada de ruido extra: $\phi$ pasa de las decenas de miles
y las encuestas se comportan como sorteos perfectos.
::: {.callout-tip collapse="true"}
## La demo de las urnas
Vamos a simular un poco. Diez casas hacen una
encuesta de 1.000 personas **la misma semana**, y el PP tiene, de verdad,
un 32 %. ¿Cuánto deberían parecerse las diez encuestas?
```{r}
#| label: fig-urnas
#| fig-height: 3.6
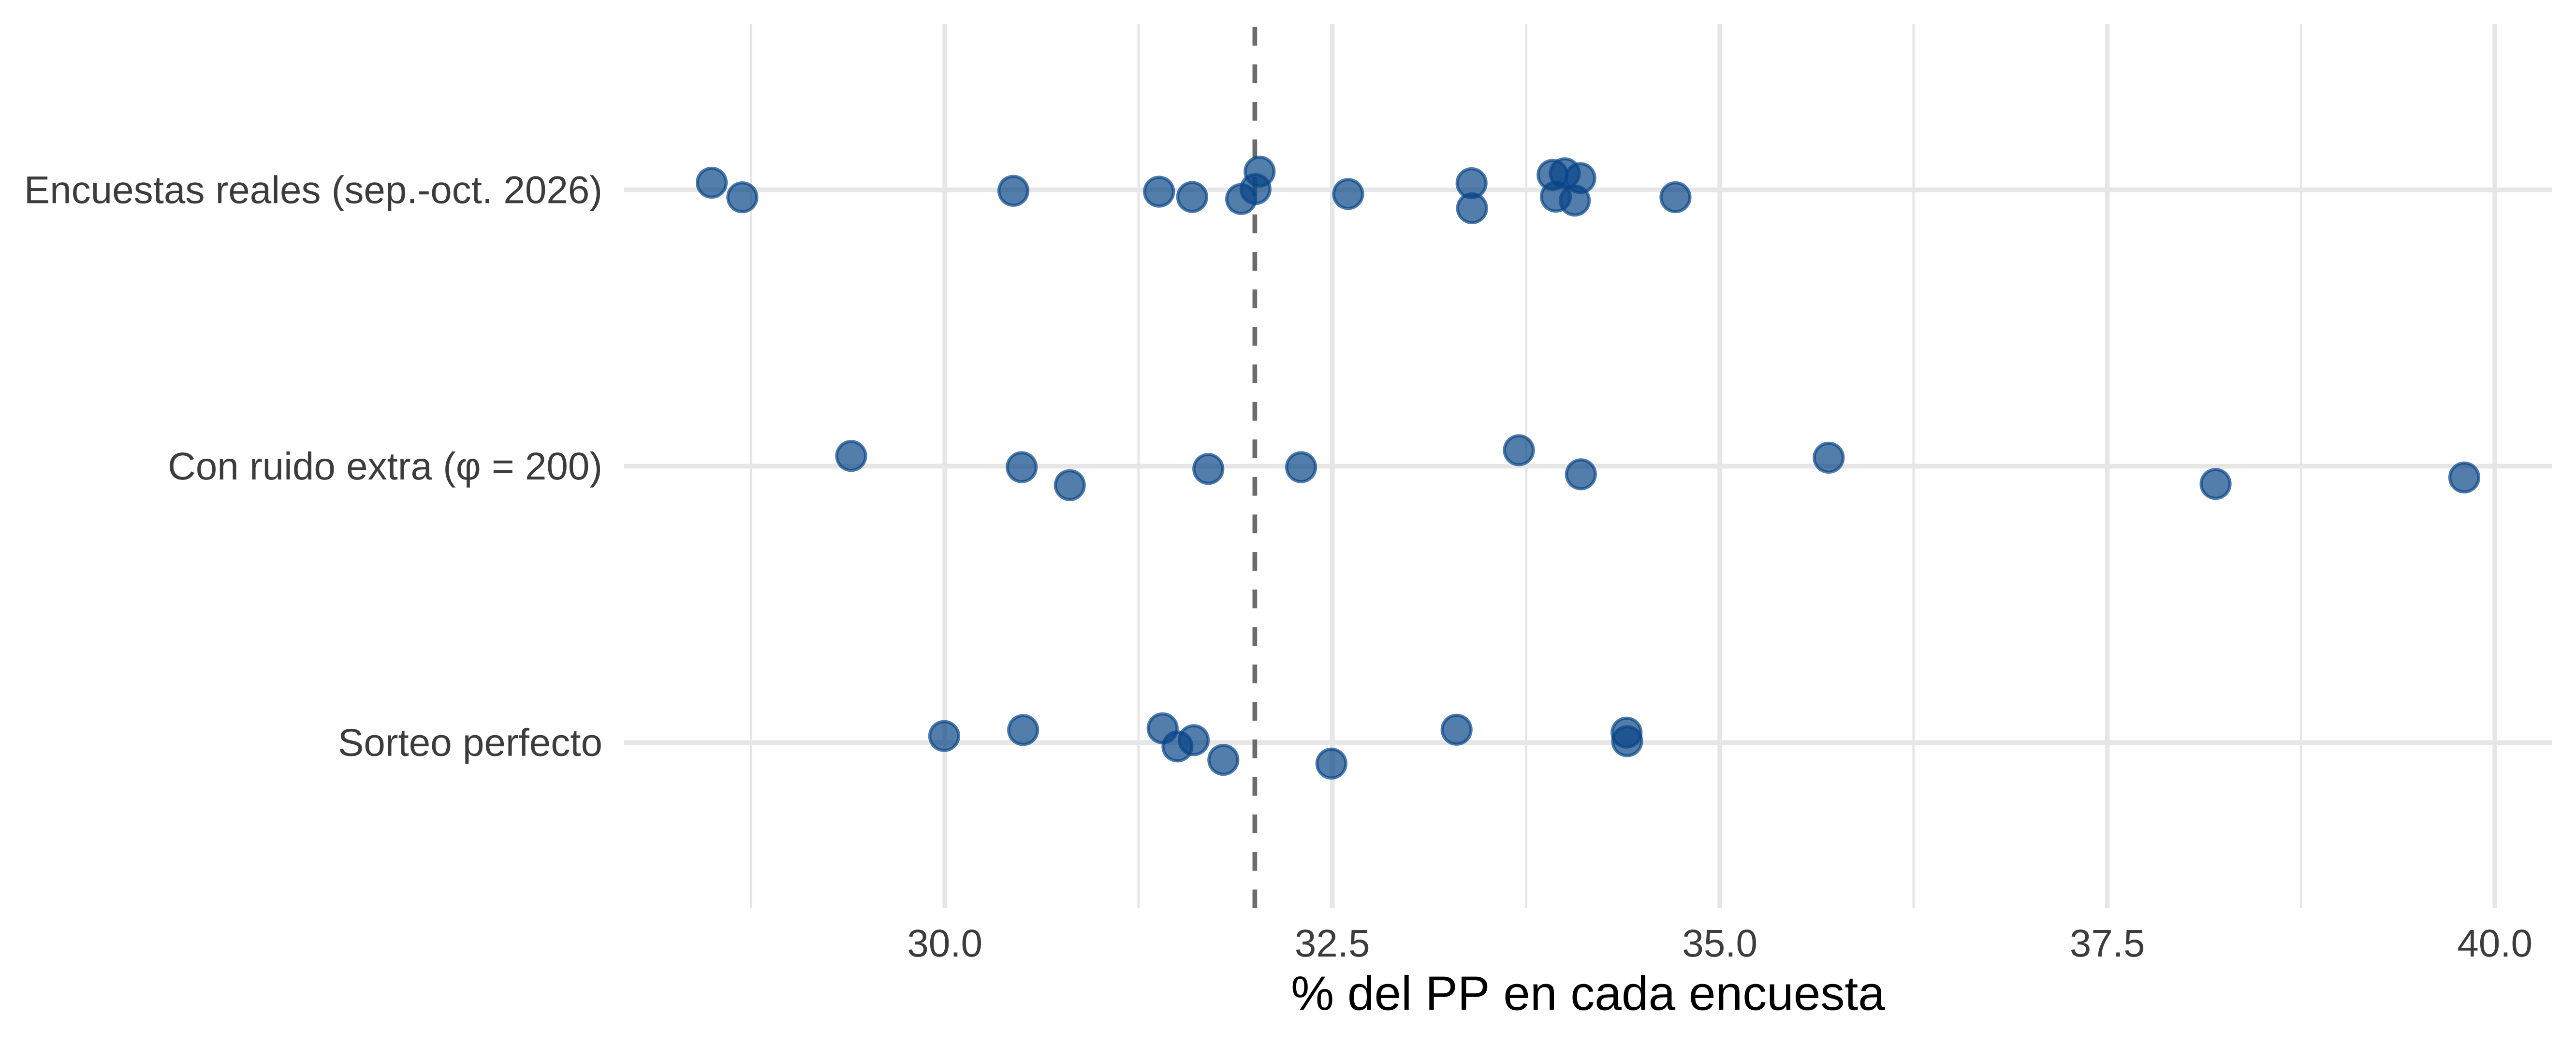
#| fig-cap: "Diez encuestas de 1.000 personas la misma semana, con un PP del 32 %: si fueran sorteos perfectos (abajo) y con ruido extra de cada encuesta (en medio). Arriba, las encuestas reales del PP en las cuatro semanas anteriores al 11 de octubre de 2026."
set.seed(2026)
n_juguete <- 1000
verdad <- 0.32
una_encuesta <- function(phi) {
  # cada encuesta saca su propia urna (una Beta, la Dirichlet de dos
  # partidos) y de ella sus 1.000 entrevistas; con phi infinito, la urna
  # es la buena
  urna <- if (is.infinite(phi)) {
    verdad
  } else {
    rbeta(1, phi * verdad, phi * (1 - verdad))
  }
  100 * rbinom(1, n_juguete, urna) / n_juguete
}
niveles <- c(
  "Sorteo perfecto",
  "Con ruido extra (φ = 200)",
  "Encuestas reales (sep.-oct. 2026)"
)
juguete <- tibble(mundo = niveles[1:2], phi = c(Inf, 200)) |>
  mutate(pp = map(phi, \(f) replicate(10, una_encuesta(f)))) |>
  unnest(pp)
reales <- grandes |>
  filter(campana == "29N-2026", fecha > as.Date("2026-09-11")) |>
  transmute(mundo = niveles[3], pp = PP)
rango <- \(m) range(juguete$pp[juguete$mundo == m])
bind_rows(juguete, reales) |>
  mutate(mundo = factor(mundo, levels = niveles)) |>
  ggplot(aes(pp, mundo)) +
  geom_vline(
    xintercept = 100 * verdad,
    linetype = "dashed",
    colour = "grey50"
  ) +
  geom_point(
    size = 3,
    alpha = 0.7,
    colour = "#005999",
    position = position_jitter(height = 0.08, seed = 1)
  ) +
  labs(x = "% del PP en cada encuesta", y = NULL) +
  theme_minimal(base_size = 12)
```
Si cada encuesta fuera un sorteo perfecto (sacar 1.000 bolas de una urna con
un 32 % de bolas azules), saldría lo de abajo: todas entre el
`r num_es(rango(niveles[1])[1])` y el `r num_es(rango(niveles[1])[2])` %.
Pero las encuestas no son sorteos perfectos. Cada una tiene su
[cocina](https://muestrear-no-es-pecado.netlify.app/2022/01/01/cocinando/): a
quién consigue llamar esa semana, cómo pondera, qué hace con los que no
recuerdan a quién votaron… Con ese ruido extra, las mismas diez encuestas
pueden irse del `r num_es(rango(niveles[2])[1])` al
`r num_es(rango(niveles[2])[2])` %, que es lo de en medio.
¿Y las de verdad? Arriba están las encuestas reales del PP de las cuatro
semanas anteriores al 11 de octubre (la línea discontinua ya no es "la
verdad" para ellas: esa no la sabemos). Van del
`r num_es(min(reales$pp))` al `r num_es(max(reales$pp))` %, a medio camino.
Pero no es una comparación limpia: mezclan casas distintas, con sus manías,
y cuatro semanas. Descontado eso, se parecen más al sorteo perfecto que al
ruido extra, y en algún partido incluso menos dispersas, como se ve más
abajo.
:::
### El rebaño
```{r}
#| label: rebano
# cociente entre la dispersión observada de las encuestas de 2026 alrededor
# del voto latente de su semana y la que daría el puro muestreo
tend_sem <- leer("conjunto_tendencia.csv") |>
  select(partido, fecha_sem = fecha, latente = mediana)
rebano <- grandes |>
  filter(campana == "29N-2026") |>
  select(fecha, n, PP, PSOE, VOX = Vox, SUMAR = Sumar) |>
  pivot_longer(
    c(PP, PSOE, VOX, SUMAR),
    names_to = "partido",
    values_to = "pct"
  ) |>
  mutate(
    fecha_sem = inicio_2026 + 7 * floor(as.numeric(fecha - inicio_2026) / 7)
  ) |>
  left_join(tend_sem, by = c("partido", "fecha_sem")) |>
  group_by(partido) |>
  summarise(
    cociente = mean((pct - latente)^2) / mean(latente * (100 - latente) / n)
  )
coc <- \(p) num_es(rebano$cociente[rebano$partido == p], 2)
```
Pero en 2026 pasa algo curioso. Si comparo cuánto se separan las
encuestas de su línea con lo que daría el sorteo puro, en el PSOE y en Vox
se separan **menos** de lo que permite el azar: el cociente entre las dos
cosas es `r coc("PSOE")` para el PSOE y `r coc("VOX")` para Vox (1 sería
sorteo puro). Es decir, las encuestas se parecen entre sí más de lo que
deberían. Es el **rebaño**: las casas se miran unas a otras y no se alejan
mucho del consenso. Se sabe, se comenta en el gremio, y aquí se ve con
números.
Y esto la Dirichlet-multinomial no lo puede recoger: solo sabe **añadir**
ruido, no quitarlo. Con $\phi$ muy grande, el modelo trata estas encuestas
como sorteos perfectos, o sea, algo más ruidosas de lo que son. Para la
predicción no es grave, porque ese parecido entre casas es justo el error
que cometen todas a la vez, y de eso se encarga la pieza siguiente.
::: {.callout-note collapse="true"}
## Detalles: cómo se identifican las tres piezas
- **Efecto casa.** Hay un efecto por casa y campaña, y dentro de cada
campaña suman cero. Así el voto latente es la media de las casas, cada
una con el mismo peso. Una casa con pocas encuestas tiene un efecto
encogido hacia cero (partial pooling).
- **Voto latente.** El paseo aleatorio prefiere pasos pequeños: un salto de
tres puntos que se deshace a la semana siguiente le sale "caro" en el
prior de la volatilidad, así que el modelo prefiere llamarlo ruido.
- **Ruido.** La Dirichlet-multinomial tiene un $\phi$ por campaña. En 2026
hay pocas encuestas por semana; la separación entre ruido y movimiento se
apoya también en las campañas pasadas, que están en el mismo modelo.
- **Lo que no se identifica:** un sesgo común a todas las casas. Es el
error del consenso, y lo mide la sección siguiente con los resultados
de las elecciones pasadas.
:::
## El error del consenso
### Dónde entra la verdad
Las encuestas solas no pueden saber si se equivocan todas a la vez: si todas
dan un punto de más al PP, para ellas eso es el voto. Para medirlo hace
falta algo que no sea una encuesta, lo que se votó de verdad en las elecciones.
De cinco de las seis campañas sabemos cómo acabaron, y ese resultado entra
en el modelo como un dato más. Es el único sitio por donde entra la verdad,
aunque no es lo único que esas cinco campañas aportan: también ayudan a
estimar la volatilidad del voto y el ruido de las encuestas, que en 2026
solo aprenderíamos con unas pocas encuestas.
En cada una de esas cinco, el modelo hace lo mismo que en 2026 (estimar el
voto latente semana a semana hasta el día de la votación), pero además lo
compara con lo que salió de las urnas:
$$
\text{error}_c = \operatorname{logit}(\text{resultado}_c) - \operatorname{logit}(\text{voto latente}_{c,T})
\ \sim\ N\big(\boldsymbol{\mu},\ \operatorname{diag}(\boldsymbol{\sigma})\,\Omega\,\operatorname{diag}(\boldsymbol{\sigma})\big)
$$
De esas comparaciones aprende cómo suele ser el error: si tira hacia un
lado con algún partido ($\boldsymbol{\mu}$), cuánto suele fallar con cada
uno ($\boldsymbol{\sigma}$) y si los fallos van juntos ($\Omega$). Y para
2026, ¿qué hacemos?, pues simplemente estimamos el voto latente y le añadimos un valor aleatorio extraído de la distribución que tenemos estimada de como fue el error en el pasado. Y eso lo hacemos en cada una de las 4000 posteriores del voto latente, uno distinto en cada "draw" de la posteriori
::: {.callout-note collapse="true"}
## Dos detalles sobre cómo se mide el error
### Por qué en logit
```{r}
#| label: ejemplo-logit
hist_pp <- read_csv(
  here::here("2026/10/errores_encuestas_historicas.csv"),
  show_col_types = FALSE
) |>
  group_by(eleccion) |>
  summarise(encuestas = mean(PP), real = mean(PP + e_PP)) |>
  mutate(
    puntos = real - encuestas,
    logit = qlogis(real / 100) - qlogis(encuestas / 100)
  )
h <- \(e, col) hist_pp[[col]][hist_pp$eleccion == e]
```
¿Y en qué escala se mide el error? En puntos sería lo natural, pero dos
puntos no son lo mismo para un partido del 32 % que para uno del 3 %. En el
28A las encuestas daban al PP un `r num_es(h("28a", "encuestas"))` % y sacó
un `r num_es(h("28a", "real"))` %: `r num_es(abs(h("28a", "puntos")))` puntos
menos. En el 23J le daban un `r num_es(h("23j", "encuestas"))` % y sacó un
`r num_es(h("23j", "real"))` %: `r num_es(abs(h("23j", "puntos")))` puntos
menos. ¿Fallaron mucho más en 2019? En puntos, unas
`r num_es(h("28a", "puntos") / h("23j", "puntos"), 0)` veces más. Pero un PP
del 17 % y uno del 34 % no son el mismo partido: fallar tres puntos con un
PP pequeño es más grave. En logit (cada partido frente a todos los demás),
el error de 2019 es `r num_es(h("28a", "logit"), 2)` y el de 2023,
`r num_es(h("23j", "logit"), 2)`: unas
`r num_es(h("28a", "logit") / h("23j", "logit"), 0)` veces más. El logit
pone a los partidos grandes y pequeños en la misma escala, y deja comparar
elecciones aunque los partidos cambien de tamaño.
### Por qué contra el voto latente
En el primer post de metanálisis medía el error de las encuestas contra la media de las encuestas
de la última semana, y luego lo sumaba a la tendencia del modelo. Parece lo
mismo, pero no lo es: en la media de las encuestas, la casa que más publica
pesa más; en el voto latente, todas las casas pesan igual.
Un ejemplo inventado: la casa A publica cinco encuestas la última semana y
da al PP un 35 %; otras cuatro casas publican una cada una y le dan un 32 %.
La media de las encuestas es un 33,7 %; la de las casas, un 32,6 %. El PP
saca un 33 %. Contra la media de las encuestas, "lo sobrestimaron"; contra
la de las casas, "lo infraestimaron". Cambia hasta el signo. Si aprendes a
corregir una cosa y luego corriges otra, la puedes liar.
Ahora el error se mide contra el voto latente de las campañas pasadas,
hecho con las mismas reglas que el de 2026. Y como todo se estima a la vez,
el resultado también ayuda a situar el voto latente de las campañas
antiguas, que a veces tenían pocas encuestas, y la duda que queda entra en
el error.
:::
### Lo que aprende
```{r}
#| label: tabla-error
p_dia_e <- c(PP = 0.32, PSOE = 0.265, VOX = 0.185, SUMAR = 0.09)
err_tab <- par_cj |>
  filter(parametro %in% c("mu_gen", "sigma_gen")) |>
  select(parametro, partido, mediana) |>
  pivot_wider(names_from = parametro, values_from = mediana) |>
  mutate(
    a_puntos = 100 * p_dia_e[partido] * (1 - p_dia_e[partido]),
    sesgo = mu_gen * a_puntos,
    tamano = sigma_gen * a_puntos,
    partido = recode(partido, VOX = "Vox", SUMAR = "Sumar + Podemos")
  )
knitr::kable(
  err_tab |>
    transmute(
      Partido = partido,
      `Sesgo típico (puntos)` = num_es(sesgo, 1),
      `Tamaño típico del fallo (puntos)` = num_es(tamano, 1),
      `Tamaño (logit)` = num_es(sigma_gen, 2)
    ),
  align = "lrrr"
)
```
Va en puntos, aproximados con el tamaño actual de cada partido. El sesgo
positivo del PSOE quiere decir que las encuestas se suelen quedar algo
cortas con él. Y el tamaño típico del fallo es lo que más ensancha las
horquillas: unos tres puntos con el PP.
Falta la otra mitad de la matriz de covarianzas del error,
$\Sigma = \operatorname{diag}(\boldsymbol{\sigma}^{\text{gen}})\,\Omega\,\operatorname{diag}(\boldsymbol{\sigma}^{\text{gen}})$.
El $\boldsymbol{\sigma}^{\text{gen}}$ es lo que falla cada partido por su
lado: la columna "Tamaño (logit)" de la tabla de arriba (la versión en
puntos depende del tamaño del partido; el logit, no). Y $\Omega$ es la
correlación entre los fallos de cada par de partidos: la diagonal lleva
unos, y las seis casillas que quedan dicen si dos partidos fallan a la vez
(+1), al revés (-1) o cada uno por su lado (0). Casilla a casilla:
```{r}
#| label: omega-completa
# la matriz Omega completa, casilla a casilla, con la contracción de cada una
om_v <- \(p) par_cj$mediana[par_cj$parametro == "Omega" & par_cj$partido == p]
om_tab <- par_cj |>
  filter(parametro == "Omega") |>
  left_join(
    leer("contraccion_conjunto.csv") |>
      filter(parametro == "Omega") |>
      select(partido, contraccion),
    by = "partido"
  ) |>
  arrange(match(
    partido,
    c(
      "PSOE-PP",
      "VOX-PP",
      "VOX-PSOE",
      "SUMAR-PP",
      "SUMAR-PSOE",
      "SUMAR-VOX"
    )
  )) |>
  transmute(
    `Fallo entre` = recode(
      partido,
      "PSOE-PP" = "PP y PSOE",
      "VOX-PP" = "PP y Vox",
      "VOX-PSOE" = "PSOE y Vox",
      "SUMAR-PP" = "PP y Sumar + Podemos",
      "SUMAR-PSOE" = "PSOE y Sumar + Podemos",
      "SUMAR-VOX" = "Vox y Sumar + Podemos"
    ),
    `Correlación (mediana)` = num_es(mediana, 2),
    IC90 = paste0(num_es(q05, 2), " a ", num_es(q95, 2)),
    Contracción = num_es(contraccion, 2)
  )
knitr::kable(om_tab, align = "lrrr")
```
Tres casillas las deciden los datos —contracción por encima de 0,8—: el
fallo con el PP y el de Vox van en direcciones opuestas
(`r num_es(om_v("VOX-PP"), 2)`), Vox y PSOE también
(`r num_es(om_v("VOX-PSOE"), 2)`), y el fallo con el PP y el del PSOE no va
junto (`r num_es(om_v("PSOE-PP"), 2)`, que también es aprender: sus fallos
van cada uno por su lado).
## Lo que enseñan las autonómicas
Cinco generales son muy poca cosa para estimar todo eso: cuatro tamaños,
cuatro sesgos y seis correlaciones, y Vox solo sale en tres. Pero las
encuestas de las autonómicas las hacen las mismas casas, con los mismos
métodos. No es lo mismo votar en unas generales que en unas autonómicas,
pero si una casa falla con el PP en las autonómicas, algo dice de cómo
puede fallar en las generales.
Uso `r dc$Ja` encuestas de la última semana en `r dc$Ea` autonómicas desde
2018 (sin las de a pie de urna). Y no las mezclo a lo loco:
| Pieza | ¿Se comparte con las generales? |
|---|---|
| Correlación entre los fallos ($\Omega$) | Sí, entera |
| Qué partidos se fallan más ($\boldsymbol{\sigma}$) | El patrón sí; el nivel, cada tipo de elección el suyo ($\gamma$) |
| Sesgo sistemático ($\boldsymbol{\mu}$) | No |
| Ruido de cada encuesta | No |
```{r}
#| label: datos-autonomicas
gamma <- par_cj |> filter(parametro == "gamma")
```
Salen dos cosas claras. La primera: $\gamma$ es
`r num_es(gamma$mediana, 2)`, prácticamente cero. Las generales fallan más o
menos lo mismo que las autonómicas.
La segunda, es interesante: la correlación entre el fallo con el PP y el
fallo con Vox, la -0,50 de la tabla de arriba. Cuando las encuestas se pasan
con el PP, se quedan cortas con Vox, y al revés.
Ojo, no dice que PP y Vox se peleen por los mismos
votantes. Dice que las encuestas se equivocan al
**repartir** el voto entre los dos, aunque se acerquen más con la suma.
## Las "manías" de las casas, frente al resultado
```{r}
#| label: tabla-casas
#| message: false
suppressMessages(library(posterior))
fit_cj <- readRDS(file.path(dir_fb, "fit_conjunto.rds"))
p_pp <- 0.32
# 1) efecto casa del PP en 2026 (cuánto se aparta del grupo); solo casas con
# encuestas de los grandes partidos
off_b <- cumsum(c(0, dc$K[match(dc$slots$campana, dc$campanas)]))[seq_len(nrow(
  dc$slots
))]
casas_grandes <- unique(dc$encuestas$casa[str_detect(
  dc$encuestas$encuesta,
  "^2026-g"
)])
slots26 <- which(dc$slots$campana == "2026" & dc$slots$casa %in% casas_grandes)
beta_pp <- sapply(slots26, \(s) {
  median(as.numeric(fit_cj$draws(
    sprintf("beta[%d]", off_b[s] + 1),
    format = "draws_matrix"
  )))
})
# 2) cuánto se pasa cada casa con el PP frente al resultado, en autonómicas
db_aut <- datos_error(
  antes_de = as.Date(fecha_elecciones),
  casas_obj = character(0)
)
aut <- db_aut$tipo[db_aut$eleccion] == 2
nombres_aut <- db_aut$casas[sort(unique(db_aut$casa[aut]))]
b_pp <- sapply(seq_along(nombres_aut), \(h) {
  median(as.numeric(fit_cj$draws(
    sprintf("b[1,%d]", h),
    format = "draws_matrix"
  )))
})
casas <- tibble(
  casa = dc$slots$casa[slots26],
  grupo = 100 * beta_pp * p_pp * (1 - p_pp)
) |>
  left_join(
    tibble(casa = nombres_aut, historia = -100 * b_pp * p_pp * (1 - p_pp)),
    by = "casa"
  ) |>
  arrange(grupo)
cor_casas <- cor(casas$grupo, casas$historia, use = "complete.obs")
media_hist <- mean(casas$historia, na.rm = TRUE)
```
¿Pero no está el efecto casa justo para esto? Sí y no. El efecto casa
responde a una pregunta: ¿esta casa se aparta del grupo? Y para eso no hace
falta saber el resultado de nada. Lo que no sabe es quién tiene razón: solo
quién va por libre. Para saber quién acierta hay que comparar con lo que se
votó, y eso es la segunda columna, que sale de las autonómicas.
Las dos columnas se parecen (correlación de `r num_es(cor_casas, 1)`): las
manías de cada casa son de verdad y se mantienen. Entonces, ¿por qué no
corrijo a cada casa por su historia? Porque el efecto casa ya devuelve a
cada una al grupo, y lo único que añadiría la historia es si el grupo entero
se pasa o se queda corto. Juntando a las casas que publican ahora, en
conjunto se pasan con el PP unas `r num_es(10 * media_hist, 0)` décimas de
punto… cuando lo que fallan todas a la vez suele ser del orden de tres
puntos. Lo probé, y corregir casa a casa no mejoraba nada. Lo que importa es
lo que fallan juntas.
::: {.callout-note collapse="true"}
## La tabla, casa por casa
```{r}
#| label: tabla-casas-detalle
knitr::kable(
  casas |>
    transmute(
      Casa = casa,
      `Se aparta del grupo en 2026 (puntos)` = num_es(grupo, 1),
      `Se pasa con el PP frente al resultado (puntos)` = if_else(
        is.na(historia),
        "sin historia",
        num_es(historia, 1)
      )
    ),
  align = "lrr"
)
```
:::
## Sumar, Podemos y el resto
Un par de cosillas más de cómo se monta el voto del 29-N.
El error del pasado solo lo conozco para la familia de Sumar entera
(Podemos e IU, Unidas Podemos, Sumar con Podemos dentro). En 2026 van por
separado, así que el error se aplica a la suma de los dos y luego se reparte
con el peso que tenga cada uno. Es decir, si las encuestas se quedan cortas
con el espacio a la izquierda del PSOE, se quedan cortas con los dos en
proporción.
## El voto del 29-N
```{r}
#| label: voto-29n
sim_cj <- readRDS(file.path(dir_fb, "conjunto_sim.rds"))
voto <- as_tibble(sim_cj$shares) |>
  select(PP, PSOE, VOX, SUMAR, PODEMOS) |>
  pivot_longer(everything(), names_to = "partido", values_to = "pct") |>
  group_by(partido) |>
  summarise(
    mediana = median(pct),
    q05 = quantile(pct, 0.05),
    q95 = quantile(pct, 0.95)
  ) |>
  arrange(desc(mediana))
knitr::kable(
  voto |>
    transmute(
      Partido = recode(
        partido,
        VOX = "Vox",
        SUMAR = "Sumar",
        PODEMOS = "Podemos"
      ),
      `Mediana (%)` = num_es(mediana),
      `Intervalo del 90 % (%)` = paste0(num_es(q05), "–", num_es(q95))
    ),
  align = "lrr"
)
der <- sim_cj$draws$PP + sim_cj$draws$VOX
```
```{r}
#| label: fig-voto
#| fig-height: 4.5
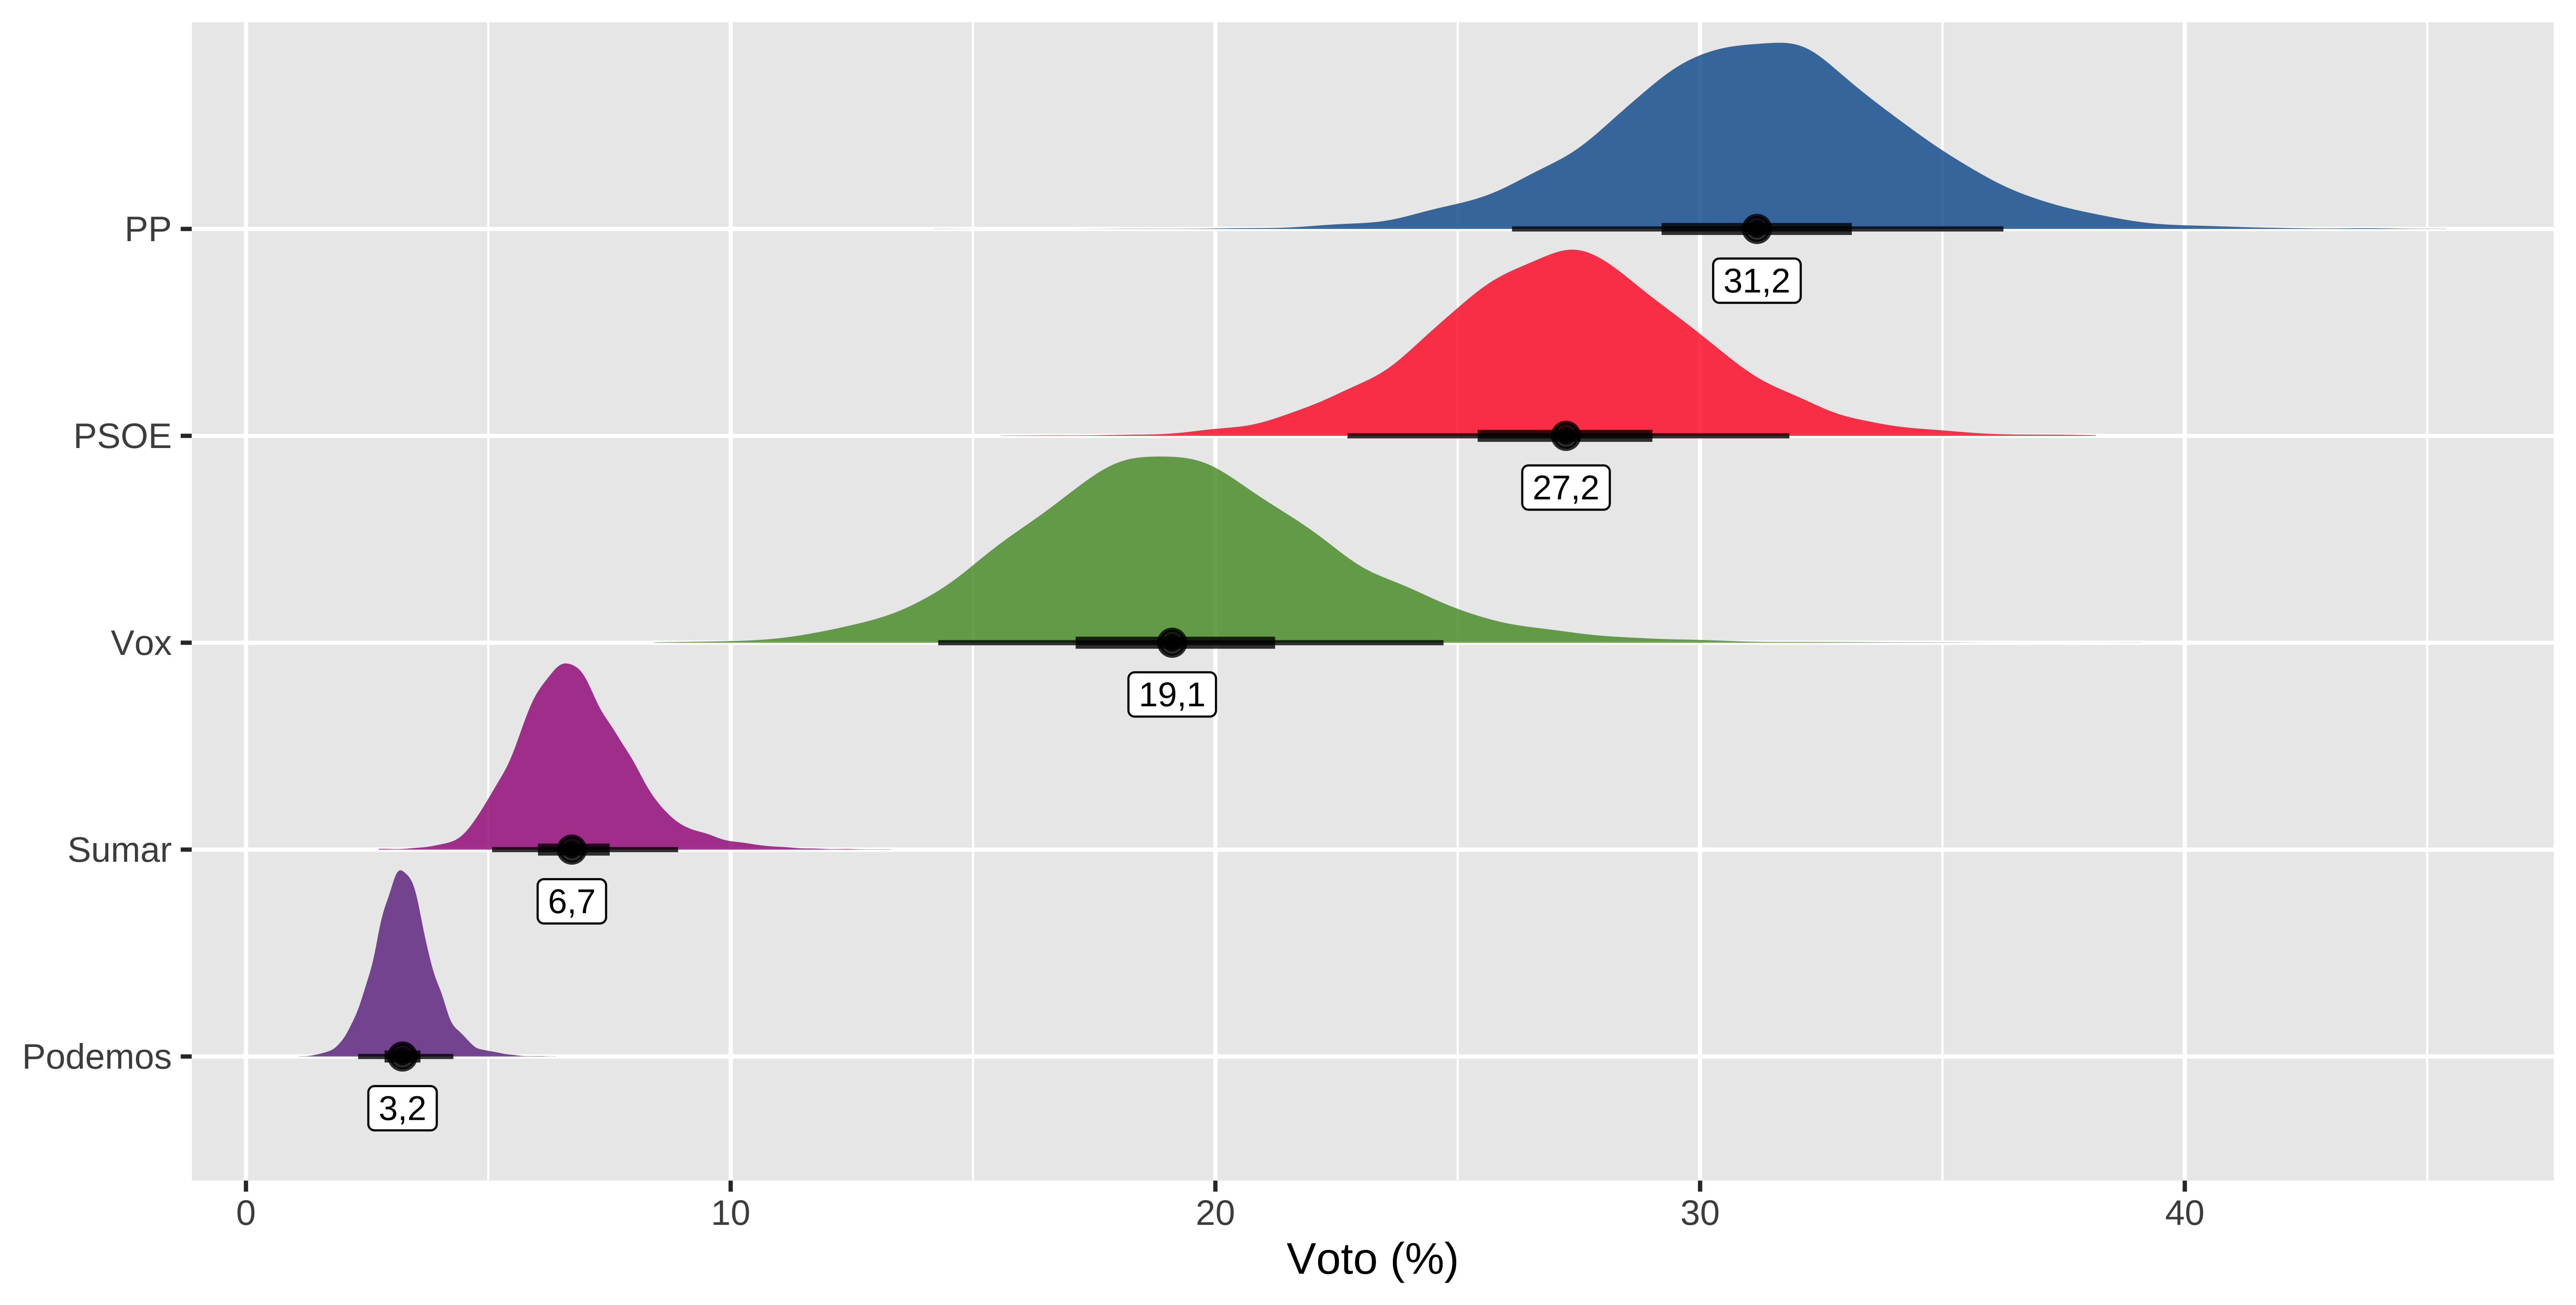
#| fig-cap: "Distribución a posteriori del voto el 29-N (6.000 simulaciones del modelo conjunto). Barra gruesa: intervalo del 50 %; fina: del 90 %. Etiqueta: mediana."
colores_voto <- c(
  "PP" = "#005999",
  "PSOE" = "#FF0126",
  "Vox" = "#51962A",
  "Sumar" = "#A00B85",
  "Podemos" = "#6B2E8C"
)
voto_draws <- as_tibble(sim_cj$shares) |>
  select(PP, PSOE, VOX, SUMAR, PODEMOS) |>
  pivot_longer(everything(), names_to = "partido", values_to = "pct") |>
  mutate(
    partido = recode(
      partido,
      VOX = "Vox",
      SUMAR = "Sumar",
      PODEMOS = "Podemos"
    ),
    partido = fct_reorder(partido, pct, .fun = median)
  )
ggplot(voto_draws, aes(x = pct, y = partido, fill = partido)) +
  # normalize = "groups": cada partido ocupa su fila; sin él, la densidad de
  # Podemos (la más estrecha) aplana las de los grandes
  ggdist::stat_halfeye(
    normalize = "groups",
    .width = c(0.5, 0.9),
    alpha = 0.8
  ) +
  geom_label(
    data = voto_draws |>
      summarise(pct = median(pct), .by = partido),
    aes(label = num_es(pct)),
    size = 3,
    fill = "white",
    nudge_y = -0.25
  ) +
  scale_fill_manual(values = colores_voto, guide = "none") +
  labs(x = "Voto (%)", y = NULL)
```
Es el voto latente de la última semana de 2026 más el error del consenso,
simulación a simulación. Teniendo el voto estimado (el latente más el error histórico), podemos meter toda la movida de como repartir los escaños, que ya he contado en post anteriores.
```{r}
#| label: escanos-adelanto
knitr::kable(
  esc_cj |>
    arrange(desc(etiqueta)) |>
    transmute(
      Partido = recode(
        partido,
        VOX = "Vox",
        SUMAR = "Frente Amplio (Sumar)",
        PODEMOS = "Podemos",
        AA = "Adelante Andalucía"
      ),
      `Escaños (mediana)` = mediana,
      `Intervalo del 90 %` = paste0(round(q05), "–", round(q95)),
      `Reparto que suma 350` = etiqueta
    ),
  align = "lrrr"
)
```
Las medianas de cada partido no tienen por qué sumar 350. La última columna
reparte los 350 escaños por resto mayor, para quien quiera un número por
partido.
PP y Vox suman `r median(der)` escaños de mediana (intervalo del 90 %:
`r round(quantile(der, 0.05))`–`r round(quantile(der, 0.95))`), y alcanzan la
mayoría absoluta en el `r pct_es(p_cj)` de las simulaciones. Con el pipeline
de octubre, el `r pct_es(p_oct)`.
Las horquillas de cada partido son anchas, y la de Vox, la que más. Salen
de dos sitios: lo que suelen fallar las encuestas todas a la vez, que en el
pasado fue del orden de tres puntos con el PP, y las `r sem_29n` semanas sin
encuestas que quedan hasta el 29-N. La de la suma de PP y Vox es más
estrecha en proporción, por la correlación negativa: cuando las encuestas
fallan con uno, suelen fallar al revés con el otro.
## ¿Nos lo creemos?
Un intervalo del 90 % promete algo muy concreto: nueve de cada diez veces,
el resultado cae dentro. Si cae siempre dentro, es demasiado ancho; si cae
fuera a menudo, demasiado estrecho. ¿Lo cumple? Para saberlo hice lo único
que se puede hacer: viajar al pasado.
Me puse en la víspera de cuatro generales (26J-2016, 28A-2019, 10N-2019 y
23J-2023), con solo lo que se sabía entonces: las encuestas de su campaña,
las generales de antes y las autonómicas de antes. Ajusté el modelo, predije
votos y escaños y miré dónde cayó el resultado de verdad.
```{r}
#| label: backtest
bt <- leer("backtest_conjunto_resumen_principal_26j_28a_10n_23j.csv") |>
  filter(version %in% c("actual", "conjunto_principal_26j_28a_10n_23j")) |>
  mutate(
    version = if_else(
      version == "actual",
      "Pipeline de octubre",
      "Modelo nuevo"
    )
  )
bt_m <- leer("backtest_conjunto_mayorias_principal_26j_28a_10n_23j.csv")
bt_esc <- leer("backtest_conjunto_escanos_principal_26j_28a_10n_23j.csv")
fallo <- bt_esc |> filter(!dentro)
knitr::kable(
  bt |>
    arrange(tipo, version) |>
    transmute(
      Qué = tipo,
      Versión = version,
      `El real cae dentro del IC90` = paste(
        round(cobertura_ic90 * celdas),
        "de",
        celdas
      ),
      `Posición del real (calibrado ≈ 0,49)` = num_es(posicion_media, 2),
      `Ancho medio del IC90` = num_es(ancho_medio_ic90, 1)
    ),
  align = "llrrr"
)
```
Este modelo nuevo falla una vez, a cambio de horquillas más anchas. El fallo es el PP
del `r toupper(fallo$eleccion[1])`: sacó `r fallo$real[1]` escaños y el
modelo daba entre `r fallo$q05[1]` y `r fallo$q95[1]`.
La columna de la posición afina más: dice en qué parte del intervalo cae el
resultado, 0 si cae en el centro y 1 si cae en el borde. En un intervalo
bien calibrado ronda 0,49. En voto, el modelo nuevo está casi clavado; en
escaños, un pelín prudente.
En 2023, cuando casi todo el mundo daba por
hecha la mayoría de PP y Vox, el modelo, con lo que se sabía la víspera, le
habría dado un `r pct_es(bt_m$p_pp_vox_176[bt_m$eleccion == "23j"])`. Una
moneda al aire. Sumaron `r bt_m$real_pp_vox[bt_m$eleccion == "23j"]`.
Con cuatro elecciones, esto dice que el modelo no está mal calibrado, no
que sea perfecto. Y hay una cosa que el backtest no puede probar: en las
elecciones pasadas, la última encuesta estaba a seis días de la votación, y
en 2026 quedan `r sem_29n` semanas. Esa parte de la horquilla se apoya en la
volatilidad estimada, no en una validación.
::: {.callout-note collapse="true"}
## Más comprobaciones: diagnósticos, priors y qué aprende el modelo
```{r}
#| label: comprobaciones
diag_cj <- leer("conjunto_diagnostico.csv")
prior_pp <- leer("conjunto_prior_predictive.csv")
contr <- leer("contraccion_conjunto.csv")
pp_prior <- \(p, col) prior_pp[[col]][prior_pp$partido == p]
```
- **Diagnósticos de Stan.** `r diag_cj$divergencias` divergencias, $\hat{R}$
máximo de `r num_es(diag_cj$rhat_max, 3)` y un tamaño efectivo mínimo de
`r round(diag_cj$ess_bulk_min)` muestras. En los ajustes del backtest de
2016 y 2019, con muy poca historia detrás, hubo unas pocas divergencias.
- **Prior predictive.** Solo con los priors, antes de ver los datos, el
modelo deja al PP entre el `r num_es(pp_prior("PP", "q05"))` y el
`r num_es(pp_prior("PP", "q95"))` % y a Vox entre el
`r num_es(pp_prior("VOX", "q05"))` y el `r num_es(pp_prior("VOX", "q95"))` %.
No sabe casi nada, pero no admite locuras.
- **Qué aprende de los datos y qué pone el prior.** La contracción compara
la incertidumbre del prior con la del posterior: cerca de 1, lo deciden
los datos; cerca de 0, el prior.
::: {.callout-note collapse="true"}
## La tabla completa de contracción
```{r}
#| label: tabla-contraccion
etiqueta_par <- c(
  sigma_gen = "Tamaño del error en generales",
  Omega = "Correlación del error",
  mu_gen = "Sesgo en generales",
  gamma = "Nivel generales frente a autonómicas",
  tau_rw = "Diferencia de volatilidad entre campañas",
  kappa = "Efecto de la campaña",
  sigma_rw = "Volatilidad semanal"
)
knitr::kable(
  contr |>
    filter(parametro %in% names(etiqueta_par)) |>
    filter(!(parametro == "sigma_rw" & !partido %in% c("PP", "VOX"))) |>
    arrange(desc(contraccion)) |>
    transmute(
      Parámetro = etiqueta_par[parametro],
      Partido = coalesce(partido, ""),
      Contracción = num_es(contraccion, 2)
    ),
  align = "llr"
)
```
:::
Lo que más pesa en la predicción (el tamaño del error y la correlación
PP–Vox) lo deciden los datos. Lo que pone sobre todo el prior son las
correlaciones con Sumar y, en parte, el sesgo y la volatilidad de Vox. Es lo
que hay con tan pocas generales con Vox.
:::
## Todos los supuestos principales
| Supuesto | De dónde sale | ¿Puesto a prueba? |
|---|---|---|
| El voto latente es un paseo aleatorio, con volatilidad propia de cada campaña | Modelo | Sí: backtest |
| El consenso es la media de las casas, cada una con el mismo peso | Decisión | No |
| El error del consenso es normal en logit, con sesgo, tamaño y correlación | Modelo | Sí: backtest |
| Las autonómicas comparten con las generales la correlación y el patrón de los fallos | Decisión | En parte: contracción y backtest |
| Sin CIS ni ElectoPanel en los grandes partidos (ElectoPanel sí en el desglose regional) | Decisión | No |
| Encuestas que no separan la izquierda fuera del PSOE (Sigma Dos, Winston, Ateneo del Dato, Data10): entran agregadas, con celda Sumar + Podemos y SALF sin observar | Regla | No |
| Encuestas antiguas sin tamaño publicado: 1.000 personas | A mano | No |
::: {.callout-tip collapse="true"}
## Reproducir el análisis
Todo está en [`2026/10/full-bayesian/`](https://github.com/joscani/blog_quarto/tree/master/2026/10/full-bayesian):
- [`01_datos.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/01_datos.R): los datos que comparte con el pipeline de octubre (errores de las generales pasadas y de las autonómicas).
- [`06_scrapear_autonomicas.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/06_scrapear_autonomicas.R): las encuestas de las autonómicas (Wikipedia).
- [`11_datos_conjunto.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/11_datos_conjunto.R): los datos del modelo.
- [`modelo_conjunto.stan`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/modelo_conjunto.stan): el modelo.
- [`12_ajustar_conjunto.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/12_ajustar_conjunto.R): el ajuste y los escaños.
- [`13_backtest_conjunto.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/13_backtest_conjunto.R): el backtest.
- [`14_contraccion.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/14_contraccion.R): qué aprende el modelo y qué pone el prior.
- [`15_dag.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/15_dag.R): el DAG del modelo.
- [`16_ablacion_error.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/16_ablacion_error.R): la ablación del error, desde el ajuste conjunto (la tabla de la descomposición de la horquilla del PP).
- [`17_sensibilidad_omega.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/17_sensibilidad_omega.R): la sensibilidad de la correlación del error (el párrafo del matiz sobre la Omega).
- [`05_comparar.R`](https://github.com/joscani/blog_quarto/blob/master/2026/10/full-bayesian/05_comparar.R): la referencia "Pipeline de octubre" de la figura de resultados y la tabla de la ablación.
n
Los ajustes guardados (`.rds`) no están en el repositorio porque pesan
mucho: están en la release
[`full-bayesian-29n`](https://github.com/joscani/blog_quarto/releases/tag/full-bayesian-29n).
:::
Como siempre, esto es un ejercicio para mi
propia diversión, así que puede haber alguna burrada , se agradecen comentarios