Show the code
library(tidyverse)

source(here::here("2026/10/preparar_meta.R"))
source(here::here("2026/10/simular_escanos.R"))Esta es la segunda parte del meta-análisis de las generales del 29 de noviembre de 2026. En la primera parte agregué las encuestas con un modelo bayesiano (brms): un multinomial de 6 categorías para los grandes (con efecto casa y tendencia temporal) y otro condicional para la composición del BLOQUE. El resultado es, muestra a muestra, un vector de 13 porcentajes: PP, PSOE, VOX, SUMAR (= Sumar + Podemos), SALF y el BLOQUE de otros repartido en Junts, ERC, PNV, EH Bildu, BNG, CC, UPN y RESTO.
Aquí va la traducción de esos porcentajes a escaños: provincia a provincia, con el ruido geográfico calibrado con la historia, la capa de error de las encuestas el día de la votación y D’Hondt.
library(tidyverse)
source(here::here("2026/10/preparar_meta.R"))
source(here::here("2026/10/simular_escanos.R"))Vamos a la parte chunga.
En España los escaños se reparten provincia a provincia con D’Hondt, con un umbral legal del 3% de los votos válidos de cada circunscripción (LOREG art. 163), y Ceuta y Melilla eligen un diputado cada una por mayoría simple. Todo el tinglado (distribución provincial, shock jerárquico de geografía, umbral del 3% y D’Hondt) vive en simular_escanos.R.
Mismo truco que en Andalucía, pero con referencia del 23J: si en 2023 ERC sacó en Barcelona un 6,5 veces su media nacional, asumo que ese desvío se mantiene. Formalmente:
\[\tilde{\pi}_{k,p} = \pi_k \cdot r_{k,p}, \qquad r_{k,p} = \frac{\pi^{23J}_{k,p}}{\pi^{23J}_{k}}\]
y luego normalizo dentro de cada provincia. El que tenga una idea mejor, que lo comente en el blog o me escriba.
El caso SALF: “Se Acabó La Fiesta” se registró en 2024, así que en el 23J no existía. No hay manera de sacar su geografía de esa referencia. Su patrón provincial lo tomo de las Europeas de junio de 2024, su única cita con las urnas. 803.545 votos y 3 escaños, que en el Congreso se reparten muy mal para un partido así.
En la primera versión, hice como en Andalucía, una Dirichlet que moviera un poco la distribución de voto en cada provincia. La idea es que si, por ejemplo, en Granada el % de voto al PP fue 1,12 veces el % nacional, ahora sea similar, pero con una pequeña perturbación que añado con la Dirichlet.
\[ \boldsymbol{\pi}^{(s)}_p \sim \text{Dirichlet}\left(\frac{V_p}{1000}\,\boldsymbol{\pi}^{23J}_p\right), \qquad r^{(s)}_{k,p} = r_{k,p} \cdot \frac{\pi^{(s)}_{k,p}}{\pi^{23J}_{k,p}} \]
Básicamente es dividir los votos reales de 2023 por 1000. El divisor (que hace que la dispersión escale con \(1/\sqrt{V_p}\), como una muestra) fue una decisión discrecional, no validada por los datos. Su objetivo es mover más el ratio en las provincias más pequeñas.
Ejemplo para Granada.
ref13 |>
  filter(provincia == "Granada", ratio > 0) |>
  select(partido, votos, pct_prov, pct_nac, ratio) |>
  arrange(desc(pct_prov)) |>
  mutate(across(where(is.double), \(x) round(x, 2)))
#> # A tibble: 6 × 5
#>   partido  votos pct_prov pct_nac ratio
#>   <chr>    <dbl>    <dbl>   <dbl> <dbl>
#> 1 PP      185996    37.3    33.3   1.12
#> 2 PSOE    165862    33.2    31.9   1.04
#> 3 VOX      81080    16.3    12.5   1.3
#> 4 SUMAR    58567    11.7    12.4   0.94
#> 5 SALF     20674     6.02    4.62  1.3
#> 6 RESTO     7283     1.46    2.48  0.59
El PP oscila entre 1,02 y 1,21 alrededor de su 1,12; SUMAR, entre 0,66 y 1,20 alrededor de 0,94. Los partidos pequeños se mueven más en términos relativos (RESTO llega a 1,00 desde 0,59), igual que en una encuesta pequeña el error relativo es mayor para quien tiene poco voto.
granada <- prov_datos |> filter(codigo_provincia == 18)

set.seed(6137)
d <- gtools::rdirichlet(5, granada$alpha13[[1]])
ratios <- t(granada$ratio13[[1]] * t(d) / granada$pct23[[1]])

tibble(partido = fams13, ratio_23j = granada$ratio13[[1]]) |>
  bind_cols(as_tibble(t(ratios), .name_repair = \(x) {
    paste0("muestra_", 1:5)
  })) |>
  filter(ratio_23j > 0) |>
  mutate(across(where(is.double), \(x) round(x, 2)))
#> # A tibble: 6 × 7
#>   partido ratio_23j muestra_1 muestra_2 muestra_3 muestra_4 muestra_5
#>   <chr>       <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#> 1 PP           1.12      1.02      1.15      1.21      1.11      1.18
#> 2 PSOE         1.04      1.12      1.06      1.04      1.01      1.11
#> 3 VOX          1.3       1         0.98      1.22      1.39      1.3
#> 4 SUMAR        0.94      1.2       1.14      0.84      1.05      0.66
#> 5 SALF         1.3       1.35      1.26      1.16      1.09      1.23
#> 6 RESTO        0.59      1         0.7       0.58      0.5       0.52
El PP tiene el mismo ratio en Granada y en Soria, pero no la misma dispersión: Granada (unos 520 “votantes equivalentes”) tiene una sd de 0,07 y Soria (unos 52) de 0,20, tres veces más, como corresponde a una muestra diez veces menor. A mayor población que vota, más nos fiamos de su deriva respecto de lo nacional.
ruido_ratio <- function(prov, partido = "PP", n = 5000) {
  pd <- prov_datos |>
    filter(
      codigo_provincia == prov_ref$codigo_provincia[prov_ref$provincia == prov]
    )
  i <- match(partido, fams13)
  d <- gtools::rdirichlet(n, pd$alpha13[[1]])
  r <- pd$ratio13[[1]][i] * d[, i] / pd$pct23[[1]][i]
  tibble(
    provincia = prov,
    diputados = pd$escanos,
    votantes_equivalentes = sum(pd$alpha13[[1]]),
    ratio_23j = pd$ratio13[[1]][i],
    media = mean(r),
    sd = sd(r)
  )
}

set.seed(6137)
bind_rows(ruido_ratio("Granada"), ruido_ratio("Soria")) |>
  mutate(across(where(is.double), \(x) round(x, 2)))
#> # A tibble: 2 × 6
#>   provincia diputados votantes_equivalentes ratio_23j media    sd
#>   <chr>         <dbl>                 <dbl>     <dbl> <dbl> <dbl>
#> 1 Granada           7                 519.       1.12  1.12  0.07
#> 2 Soria 2 51.6 1.12 1.12 0.2La Dirichlet simula que no me fío del recuento de 2023, como si Granada fuera una encuesta con su margen de error. Pero eso fue lo que pasó de verdad: el fenómeno que querríamos modelar es el cambio de distribución provincial entre unas elecciones y otras.
Más abajo hice un backtest nacional, que no es más que utilizar las encuestas previas a las elecciones pasadas, y ver si con la aproximación con la Dirichlet los intervalos de estimación de voto y de escaños a nivel estatal son del 90%.
Para saber si a nivel provincial pasa lo mismo, procedemos igual y vemos si esos intervalos tienen cobertura del 90% teórico o no.
Como tenemos 5 elecciones anteriores x partidos con encuestas x 52 provincias salen sobre unas 936 celdas. En cada celda miro si el intervalo contiene el verdadero valor. La cobertura del 90% implicaría que en el 90% de esas celdas el intervalo contuviera al verdadero valor.
Ejemplo. Granada, 23J, PP: la simulación, que parte del ratio del 10N, le daba un IC90 de [32,4; 38,5] y sacó un 37,0. Dentro.
Lleida, 23J, PSOE: le daba [17,1; 20,4] y sacó un 29,5. Fuera por mucho. Y no es casualidad: entre el 10N y el 23J el PSC se movió en bloque en Cataluña mientras el PSOE bajaba a nivel nacional. En 2023, el PSOE (PSC) subió mucho, podríamos llamarlo efecto PSC.
El reparto provincial de cada muestra ya lo calcula el backtest nacional de más abajo, antes del umbral y D’Hondt (que no cambian shares de voto, solo escaños):
mult <- ratios[[i]] * dir_m[[i]][k, ] / q23_prov[[i]]
v <- c(tracked[k, con_datos] * mult, otros_list[[prov_i[i]]])
v <- v / sum(v)   # <- este reparto provincial es lo que ahora se guarda
La única diferencia es que en vez de tirarlo tras D’Hondt, se compara con el resultado real provincial de la elección objetivo (que infoelectoral da provincia a provincia). La celda de comparación es elección × partido × provincia. Misma configuración que el backtest nacional (geografía de la elección anterior, mu encogido a la mitad, semilla fija en el script: las variantes van emparejadas y la comparación no se contamina de ruido Monte Carlo). En los CSV y el código la columna se llama familia, herencia del backtest nacional; en el texto la llamo partido.
La cuenta global, partido por partido:
prov_celdas <- read_csv(
  here::here("2026/10/backtest_prov_celdas.csv"),
  show_col_types = FALSE
)

cobertura_de <- function(celdas) {
  con_z <- celdas |>
    filter(!ref_ratio_cero) |>
    mutate(z = (real - mediana) / ((q95 - q05) / (2 * qnorm(0.95))))
  bind_rows(
    con_z |>
      group_by(familia) |> # familia == partido , reminiscencias del primer código
      summarise(
        celdas = n(),
        cobertura = mean(dentro),
        factor_ruido = sd(z),
        .groups = "drop"
      ),
    con_z |>
      summarise(
        familia = "TOTAL",
        celdas = n(),
        cobertura = mean(dentro),
        factor_ruido = sd(z),
        .groups = "drop"
      )
  )
}

cobertura_de(prov_celdas) |>
  rename(partido = familia) |>
  mutate(across(where(is.numeric), \(x) round(x, 2)))
#> # A tibble: 5 × 4
#>   partido celdas cobertura factor_ruido
#>   <chr>    <dbl>     <dbl>        <dbl>
#> 1 PP         255      0.73         1.6
#> 2 PSOE       260      0.7          1.99
#> 3 SUMAR      259      0.59         2.39
#> 4 VOX        138      0.56         2.38
#> 5 TOTAL      912      0.66         2.09
Mis intervalos prometen un 90% y cumplen un 66%. El factor_ruido lo mide: cuántas veces habría que multiplicar el ruido para que el intervalo cumpliera lo que promete. En conjunto, unas dos veces: la distribución provincial real se mueve entre elecciones el doble de lo que la Dirichlet admite. Y el problema es de anchura, no de centro: el real cae por debajo del intervalo en un 20% de las celdas y por encima en un 16%.
¿Y por elección?
prov_celdas |>
  filter(!ref_ratio_cero) |>
  group_by(eleccion) |>
  summarise(cobertura = mean(dentro), .groups = "drop") |>
  mutate(across(where(is.numeric), \(x) round(x, 2)))
#> # A tibble: 5 × 2
#>   eleccion cobertura
#>   <chr>        <dbl>
#> 1 10n           0.8
#> 2 20d           0.49
#> 3 23j           0.63
#> 4 26j           0.7
#> 5 28a           0.62
El 10N, repetición de la anterior, sale al 80%, lo mejor de la lista: con la geografía casi congelada, el ruido actual basta. En las transiciones frescas (20D 49%, 28A 62%, 23J 63%) se cae muy por debajo. La Dirichlet estaba calibrada, sin que yo lo supiera, para el caso más fácil.
Lo de la aproximación de la Dirichlet era bastante compadre, se queda corta para los cambios que hubo en la realidad.
Como tenemos datos de elecciones pasadas, podemos intentar medir como ha cambiado la distribución provincial. Algunas elecciones se celebraron con pocos meses de diferencia y, como era de esperar, los ratios provinciales cambiaron poco. Pero las otras sí sirven para ver cuánto se mueve en cada provincia cada partido.
Pero el efecto no es solo por provincia, a veces el cambio se da en toda una comunidad, como la subida del PSC en Cataluña en 2023, y otras veces el cambio puede ser en alguna provincia concreta sin relación con la comunidad.
Con lo cual, dos efectos: uno por comunidad, cuyo resultado sufren todas sus provincias a la vez, y otro por provincia. Los llamo \(\tau_c\) (comunidad) y \(\tau_p\) (provincia). Y la idea es estimarlo a partir de los datos de elecciones anteriores.
Es importante ver el cambio de ratio, es decir cuánto más o cuánto menos se vota un partido en una provincia respecto a toda España, para separar el aumento de voto a un partido (que esto lo mide el modelo), respecto a la composición provincial de como se reparte, que es justo lo que queremos ver en este apartado
Para cada partido \(k\), transición \(t\) y provincia \(p\):
\[ \Delta \log r_{k,t,p} = \alpha_k + \delta \, \text{rep}_t + \eta_{k,c(p)} + \varepsilon_{k,p}, \qquad \eta \sim \mathcal{N}(0, \tau_{c,k}), \quad \varepsilon \sim \mathcal{N}(0, \tau_{\text{prov},k}) \]
Es lo mismo que hicimos en el meta-análisis: allá cada encuestadora tenía una desviación propia compartida por todas sus encuestas; aquí cada comunidad tiene una desviación propia compartida por todas sus provincias. En brms la respuesta va en dos partes, la media y la desviación típica, cada una con su propia regresión:
bf(
  dlr ~ 0 + partido + repeticion + (0 + partido || codigo_ccaa),
  sigma ~ 0 + celda_sigma    # celda = partido × {fresca, repetición}
)
El ajuste vive en backtest_prov_loto.R, en la función ajustar_tau_brm(), que también genera el fit completo que consume la simulación (mod_tau_shock.rds). La preparación de los Δ log r y las estimaciones puntuales con lme4 están en shock_jerarquico.R.
0 + partido + repeticion da un intercepto por partido y la dummy de repetición. Las medias de deriva salen diminutas (entre −0,05 y 0,00) y el re-centrado las elimina en la simulación; están para que los residuos queden centrados.(0 + partido || codigo_ccaa) es el \(\tau_c\): cada comunidad recibe una desviación por partido, y las cuatro desviaciones de una comunidad son independientes entre sí (la doble barra, sin correlaciones estimadas). La sd de esas desviaciones dentro de cada partido es su \(\tau_c\). Es el truco estándar para varianzas por grupo: con (1 | partido:ccaa) saldría un único \(\tau_c\) para todos los partidos juntos, y VOX se mueve en bloque por comunidad mientras el PP se mueve provincia a provincia.sigma ~ 0 + celda_sigma es el \(\tau_p\): cada celda partido × tipo de transición lleva su propia varianza y la diferencia sale directa del posterior: PP 0,173 en frescas frente a 0,050 en repeticiones; VOX 0,199 frente a 0,063.Diagnósticos: Rhat máximo 1,004, ESS mínimo 789, cero divergentes (723 observaciones y una decena de parámetros efectivos no dan para más drama).
El posterior de los dos efectos, por partido:
tau_brms <- read_csv(
  here::here("2026/10/tau_shock_brms.csv"),
  show_col_types = FALSE
) |>
  rename(partido = familia)

tau_brms |>
  mutate(
    across(where(is.numeric), \(x) round(x, 3)),
    `tau_c` = str_c(tau_c_med, " [", tau_c_ic05, ", ", tau_c_ic95, "]"),
    `tau_p` = str_c(tau_p_med, " [", tau_p_ic05, ", ", tau_p_ic95, "]")
  ) |>
  select(partido, `tau_c`, `tau_p`)
#> # A tibble: 4 × 3
#>   partido tau_c               tau_p
#>   <chr>   <chr>               <chr>
#> 1 PP      0.04 [0.026, 0.06]  0.171 [0.153, 0.193]
#> 2 PSOE    0.023 [0.01, 0.04]  0.154 [0.137, 0.173]
#> 3 SUMAR   0.057 [0.03, 0.095] 0.16 [0.143, 0.181]
#> 4 VOX     0.124 [0.09, 0.172] 0.195 [0.162, 0.234]
De la posterior saco un par de apuntes
El τ no depende apenas del tamaño de la provincia; la correlación de |Δ log r| con los votos provinciales va de −0,3 a 0. Eso desmiente el escalado de la Dirichlet, que daba una desviación de 0,06 en Granada y de 0,01 en Madrid por el mero hecho de tener más votantes.
El efecto de comunidad sale pequeño en PP (0,04) y PSOE (0,02) y grande en VOX (0,12). El PP se mueve provincia a provincia; VOX, en bloque por comunidad.
Un aviso sobre SUMAR, que conviene tener a la vista: parte de su Δ log r no es geografía, es recomposición de candidaturas. En el ciclo 2015–2016 las confluencias (En Comú, En Marea, Compromís-Podemos) e IU concurrieron por separado en el 20D y juntas como Unidos Podemos en el 26J; en el 23J Sumar integró a Compromís, Más Madrid y otros, que en 2019 habían concurrido por separado (Más País, Más Compromís).
Su τ sale por ahí algo inflado y, no por casualidad, es el peor calibrado de los cuatro: factor de ruido 1,23 frente al 0,7–1,0 del resto de partidos. Una parte de su desviación no es por cambio de distribución provincial, sino por la composición de la coalición en el pasado.
En cada muestra, el ratio del partido \(k\) en la provincia \(p\) pasa de \(r_{k,p}\) a
\[ r^{(s)}_{k,p} = r_{k,p} \cdot \exp\left(\eta_{k,c(p)} + \varepsilon_{k,p}\right) \]
O sea, el ratio de 2023 tras sumar los dos efectos en escala logarítmica y exponenciar el resultado. Al tener dos efectos, comunidad y provincia hay que normalizar de alguna forma para que no se den efectos raros.
Un ejemplo con dos provincias: A pesa el 60% de los votos, B el 40%, y los ratios de referencia valen 1,0 en las dos, así que el nacional implícito es el que toca. Un draw da exp(η+ε) = 1,10 en la comunidad de A y 0,95 en la de B. La media ponderada es 0,6·1,10 + 0,4·0,95 = 1,04: sin más, la geografía habría dado al partido un +4% de voto nacional, por encima de lo que ya decidió la capa de error. Dividiendo cada ratio entre 1,04 (A queda en 1,058, B en 0,913), la media vuelve a 1,00 y el nacional se conserva: solo mueve voto entre provincias.
comp_var <- read_csv(
  here::here("2026/10/backtest_prov_comparacion.csv"),
  show_col_types = FALSE
) |>
  rename(partido = familia)

# helpers para las cifras en línea del texto
cob_de <- function(vari, part = "TOTAL") {
  100 * comp_var$cobertura[comp_var$variante == vari & comp_var$partido == part]
}
fac_de <- function(vari, part = "TOTAL") {
  comp_var$factor_ruido[comp_var$variante == vari & comp_var$partido == part]
}
# números en línea con coma decimal (convención del texto)
num_es <- function(x, d = 2) {
  format(round(x, d), decimal.mark = ",", trim = TRUE)
}
vox_tau_p <- tau_brms |>
  filter(partido == "VOX") |>
  transmute(
    s = str_c(
      format(round(tau_p_med, 3), decimal.mark = ","),
      " [",
      format(round(tau_p_ic05, 3), decimal.mark = ","),
      "; ",
      format(round(tau_p_ic95, 3), decimal.mark = ","),
      "]"
    )
  ) |>
  pull(s)

# diagnóstico de doble conteo: la Dirichlet superpuesta al shock (con los
# draws brms)
masdir <- read_csv(
  here::here("2026/10/backtest_prov_celdas_shock_mas_dir.csv"),
  show_col_types = FALSE
) |>
  filter(!ref_ratio_cero) |>
  summarise(cobertura = mean(dentro), ancho = mean(q95 - q05))

comp_var |>
  filter(partido == "TOTAL" | variante != "dirichlet (baseline)") |>
  select(-celdas) |>
  mutate(across(where(is.numeric), \(x) round(x, 2))) |>
  arrange(variante, partido)
#> # A tibble: 11 × 5
#>    partido cobertura ancho factor_ruido variante
#>    <chr>       <dbl> <dbl>        <dbl> <chr>
#>  1 TOTAL        0.66  5.67         2.09 dirichlet (baseline)
#>  2 PP           0.96 14.6          0.73 shock brms (draws)
#>  3 PSOE         0.95 12.9          0.83 shock brms (draws)
#>  4 SUMAR        0.9   9.66         1.23 shock brms (draws)
#>  5 TOTAL        0.94 12.0          0.97 shock brms (draws)
#>  6 VOX          0.93  9.97         1.02 shock brms (draws)
#>  7 PP           0.95 13.5          0.78 shock puntual
#>  8 PSOE         0.94 11.8          0.91 shock puntual
#>  9 SUMAR        0.9   9.21         1.3  shock puntual
#> 10 TOTAL        0.92 10.9          1.08 shock puntual
#> 11 VOX          0.86  7.62         1.35 shock puntual
Tres conclusiones, por este orden:
Los τ se estiman con las cuatro transiciones y el backtest prueba esas mismas cuatro elecciones: la validación es in-sample, la misma trampa que el sesgo del PSOE antes de su leave-one-out. Así que la repito con un leave-one-transition-out (backtest_prov_loto.R): reajusto los τ sin la transición de la elección que pruebo (cuatro ajustes brms más) y vuelvo a correr el backtest provincial de esa elección, con la misma semilla en las dos corridas para que la única diferencia sean los τ.
loto_res <- read_csv(
  here::here("2026/10/backtest_prov_loto_resumen.csv"),
  show_col_types = FALSE
)

# cobertura in-sample por elección (el 20D solo tiene la variante oos)
cob_in <- function(e) {
  v <- if (e == "20d") "in-sample (oos)" else "in-sample"
  100 * loto_res$cobertura[loto_res$eleccion == e & loto_res$variante == v]
}

loto_res |>
  mutate(
    eleccion = recode(
      eleccion,
      `20d` = "20D-2015",
      `26j` = "26J-2016",
      `28a` = "28A-2019",
      `10n` = "10N-2019",
      `23j` = "23J-2023"
    ),
    variante = recode(
      variante,
      `in-sample` = "in-sample",
      `in-sample (oos)` = "in-sample (fuera de muestra)",
      `loto` = "LOTO"
    ),
    cobertura = scales::percent(cobertura, 1),
    ancho_medio = round(ancho_medio, 1)
  ) |>
  rename(
    Elección = eleccion,
    Variante = variante,
    Celdas = celdas,
    Cobertura = cobertura,
    `Ancho medio IC90` = ancho_medio
  )
#> # A tibble: 9 × 5
#>   Elección Variante                     Celdas Cobertura `Ancho medio IC90`
#>   <chr>    <chr>                         <dbl> <chr>                  <dbl>
#> 1 20D-2015 in-sample (fuera de muestra)    154 84%                     12.7
#> 2 26J-2016 LOTO                            155 99%                     13.1
#> 3 26J-2016 in-sample                       155 99%                     13.2
#> 4 28A-2019 LOTO                            189 90%                     11.5
#> 5 28A-2019 in-sample                       189 90%                     11.2
#> 6 10N-2019 LOTO                            207 99%                     11.2
#> 7 10N-2019 in-sample                       207 99%                     11.5
#> 8 23J-2023 LOTO                            207 95%                     11.7
#> 9 23J-2023 in-sample                       207 96%                     11.8
La cobertura no se mueve: LOTO e in-sample dan lo mismo en las cuatro elecciones (las diferencias entre corridas son del orden de una celda, ruido de Monte Carlo). Los τ no están sobreajustados a las transiciones que los calibran. Y el caso más limpio es el 20D: su geografía viene del 11D, que no entra en la calibración, así que ahí la geografía probada es de verdad fuera de muestra (la capa de error y el supuesto del ratio se evalúan igual en las cinco elecciones), y sube del 49% con la Dirichlet al 84% con el shock. La primera vez que la maquinaria se enfrenta a una distribución provincial que no ha visto, cubre cerca de lo que promete.
Y el alcance del experimento: el LOTO habla de la calibración del ruido territorial, no de toda la cadena. La capa de error nacional, el supuesto del ratio y la agregación de encuestas los prueba el backtest nacional de más abajo, que sí recorre la predicción completa.
El cambio provincial ya vive en simular() y es el ruido provincial por defecto (modo_ruido = "shock"). Para eso hacían falta los τ de los partidos regionales, que hasta ahora solo tenían los 4 grandes. Y aquí me topé con un lío conceptual: para un partido que solo compite en una comunidad, la descomposición comunidad/provincia de los grandes no se puede estimar, porque no hay contraste entre comunidades. Así que lo parto en dos etapas, con los saltos frescos de candidaturas limpias (26J→28A y 10N→23J, los únicos donde las siglas no cambian de significado): τ_p es la dispersión provincial dentro de cada salto, que aguanta cambios de composición uniformes (desplazan la media, no la sd), y τ_c la desviación típica entre medias de salto, corregida por \(\tau_p^2/P\). Con dos saltos es frágil, lo reconozco, pero es lo único que se me ocurre para el movimiento en bloque de la comunidad, que solo asoma en ERC y Junts.
read_csv(
  here::here("2026/10/tau_regionales.csv"),
  show_col_types = FALSE
) |>
  rename(partido = familia) |>
  select(partido, tau_p, tau_c, tau_total, fuente) |>
  mutate(across(where(is.numeric), \(x) round(x, 3)))
#> # A tibble: 7 × 5
#>   partido  tau_p tau_c tau_total fuente
#>   <chr>    <dbl> <dbl>     <dbl> <chr>
#> 1 BNG      0.106 0         0.106 estimado
#> 2 CC       0.09  0         0.09  estimado
#> 3 EH Bildu 0.107 0         0.107 estimado
#> 4 ERC      0.068 0.161     0.175 estimado
#> 5 Junts    0.048 0.107     0.118 estimado
#> 6 PNV      0.067 0         0.067 estimado
#> 7 UPN 0.115 0 0.115 heredado (RMS del resto)En este apartado es donde tengo bastantes dudas de lo que he hecho. Creo que necesita ser más trabajado. La idea es que puede que las encuestas hayan subestimado o sobreestimado a algún partido en particular de forma sistemática, y corregir en cierta forma ese sesgo.
Para cada elección pasada, comparo el resultado real con la media de las encuestas cuyo trabajo de campo terminó en los últimos días de campaña: 124 encuestas de las cinco últimas generales, sacadas de los anexos de sondeos de Wikipedia (con su fecha de fin de campo, que en esas tablas viene en rangos tipo “15–19 Abr”) y congeladas en errores_encuestas_historicas.csv. Quedan fuera los sondeos internos de partidos que también publican los anexos: no son estimaciones públicas. Para el PSOE sale esto:
errores_hist <- read_csv(
  here::here("2026/10/errores_encuestas_historicas.csv"),
  show_col_types = FALSE
)

etiquetas <- c(
  `20d` = "20D-2015",
  `26j` = "26J-2016",
  `28a` = "28A-2019",
  `10n` = "10N-2019",
  `23j` = "23J-2023"
)

errores_hist |>
  group_by(eleccion) |>
  summarise(encuesta = mean(PSOE), error = mean(e_PSOE), .groups = "drop") |>
  mutate(real = encuesta + error) |>
  arrange(match(eleccion, names(etiquetas))) |>
  mutate(eleccion = etiquetas[eleccion]) |>
  relocate(eleccion, encuesta, real, error) |>
  mutate(across(where(is.numeric), \(x) round(x, 2))) |>
  rename(Elección = eleccion, Encuestas = encuesta, Real = real, Error = error)
#> # A tibble: 5 × 4
#>   Elección Encuestas  Real Error
#>   <chr>        <dbl> <dbl> <dbl>
#> 1 20D-2015      21.1  22.0  0.94
#> 2 26J-2016      21.2  22.6  1.37
#> 3 28A-2019      28.8  28.7 -0.09
#> 4 10N-2019      27.1  28    0.89
#> 5 23J-2023      28.2  31.7  3.49
Positivo en cuatro de las cinco (el 28A-2019 queda en un ±0). Por lo que he visto, de los cuatro partidos principales, el único cuyo sesgo es consistente es el PSOE (+1,3 puntos: positivo en 4 de 5 elecciones, y sigue en +1,3 si excluyo el 26J, que solo tiene 2 encuestas). Pero con cinco elecciones la media muestral de ese sesgo es una estimación ruidosa, y lo compruebo con un leave-one-out: aplicada fuera de muestra, la corrección completa no mejora la predicción. El 28A paga la factura, con sesgo real ~0 y corrección de +1,7 estimada sin él. Así que la aplico encogida a la mitad (+0,7): la evidencia apunta a que el sesgo existe, pero cinco elecciones no bastan para fijar su tamaño. Y el backtest de más abajo, con sus 18 celdas, no distingue entre corregir todo, la mitad o nada; me quedo con la mitad como compromiso.
Para PP, VOX y Sumar el mu cambia de signo según qué elecciones entren, así que su μ va a 0. La capa funciona así: a cada muestra del posterior se le suma un error muestreado de una normal multivariante con media +0,7 para el PSOE y 0 para el resto y una desviación típica por partido de 1,3 a 2,6 puntos, que es cuánto se equivocan las encuestas en conjunto con cada uno. La única correlación que lleva es PP–VOX a +0,5: cuando las encuestas se pasan con el bloque del PP, se pasan también con VOX, como ocurrió en las tres elecciones con VOX (la correlación empírica es +0,92 y con n = 3 la encogí). El resto de correlaciones es inestable con 5 elecciones y va a 0. Es la conclusión contraria de la que puse a mano en Andalucía: el trasvase de voto útil PP–VOX es dinámica de campaña que el modelo ya captura con las pendientes temporales, y esto va sobre otra cosa, cómo se equivocan las encuestas el día de la votación.
Tras sumar el error, el vector completo se reescala para que siga sumando 100: cada partido cede en proporción a su tamaño. El BLOQUE no carga con el residual (en la primera versión sí: absorbía todo el error de los grandes, incluida la corrección del PSOE, sin que ningún dato diga que los regionales compensen al PSOE). Recibe en cambio un shock propio \(\mathcal{N}(0;\, 1{,}5^2)\), supuesto explícito: la historia no puede calibrarlo, allí el bloque es el residual de los grandes por construcción. SALF se queda fuera: no existía antes de 2024 y no tiene historia.
# la capa de error tal como vive en simular_escanos.R
# (la fila del BLOQUE es el supuesto propio, no sale de la calibración)
tibble(partido = names(error_mu), mu = error_mu, sigma = error_sigma) |>
  add_row(partido = "BLOQUE", mu = 0, sigma = 1.5)
#> # A tibble: 6 × 3
#>   partido    mu sigma
#>   <chr>   <dbl> <dbl>
#> 1 PP       0     2.57
#> 2 PSOE     0.66  1.32
#> 3 VOX      0     1.29
#> 4 SUMAR    0     1.89
#> 5 SALF     0     0
#> 6 BLOQUE   0     1.5
Sobre el impacto: esta incertidumbre no solo ensancha los intervalos (los duplica: el IC90 de PP+VOX pasa de 16 a 30 escaños), también desplaza la estimación: el PSOE gana escaños y la probabilidad de mayoría de PP+VOX baja del 100,0% de los posteriors a secas al 98,0%. Es una corrección estimada con solo 5 elecciones: mejor que nada, peor que calibrar por casa, que sigue pendiente. En el código vive en extraer_shares13(con_error = TRUE); la validación del 23J va sin ella.
Un par de detalles
Para ver que el mecanismo de asignación de escaños funciona bien, lo aplico a los datos del 23J
Le doy a la simulación los porcentajes nacionales reales del 23J y sus ratios de referencia, sin ruido, y debe reproducir los escaños oficiales:
v23 <- sim_validacion_23j()

tibble(
  partido = names(v23),
  simulado = v23,
  oficial_23j = c(137, 121, 33, 31, 0, 7, 7, 5, 6, 1, 1, 1, 0)
)
#> # A tibble: 13 × 3
#>    partido  simulado oficial_23j
#>    <chr>       <dbl>       <dbl>
#>  1 PP            137         137
#>  2 PSOE          121         121
#>  3 VOX            33          33
#>  4 SUMAR          31          31
#>  5 SALF            0           0
#>  6 Junts           7           7
#>  7 ERC             7           7
#>  8 PNV             5           5
#>  9 EH Bildu        6           6
#> 10 BNG             1           1
#> 11 CC              1           1
#> 12 UPN             1           1
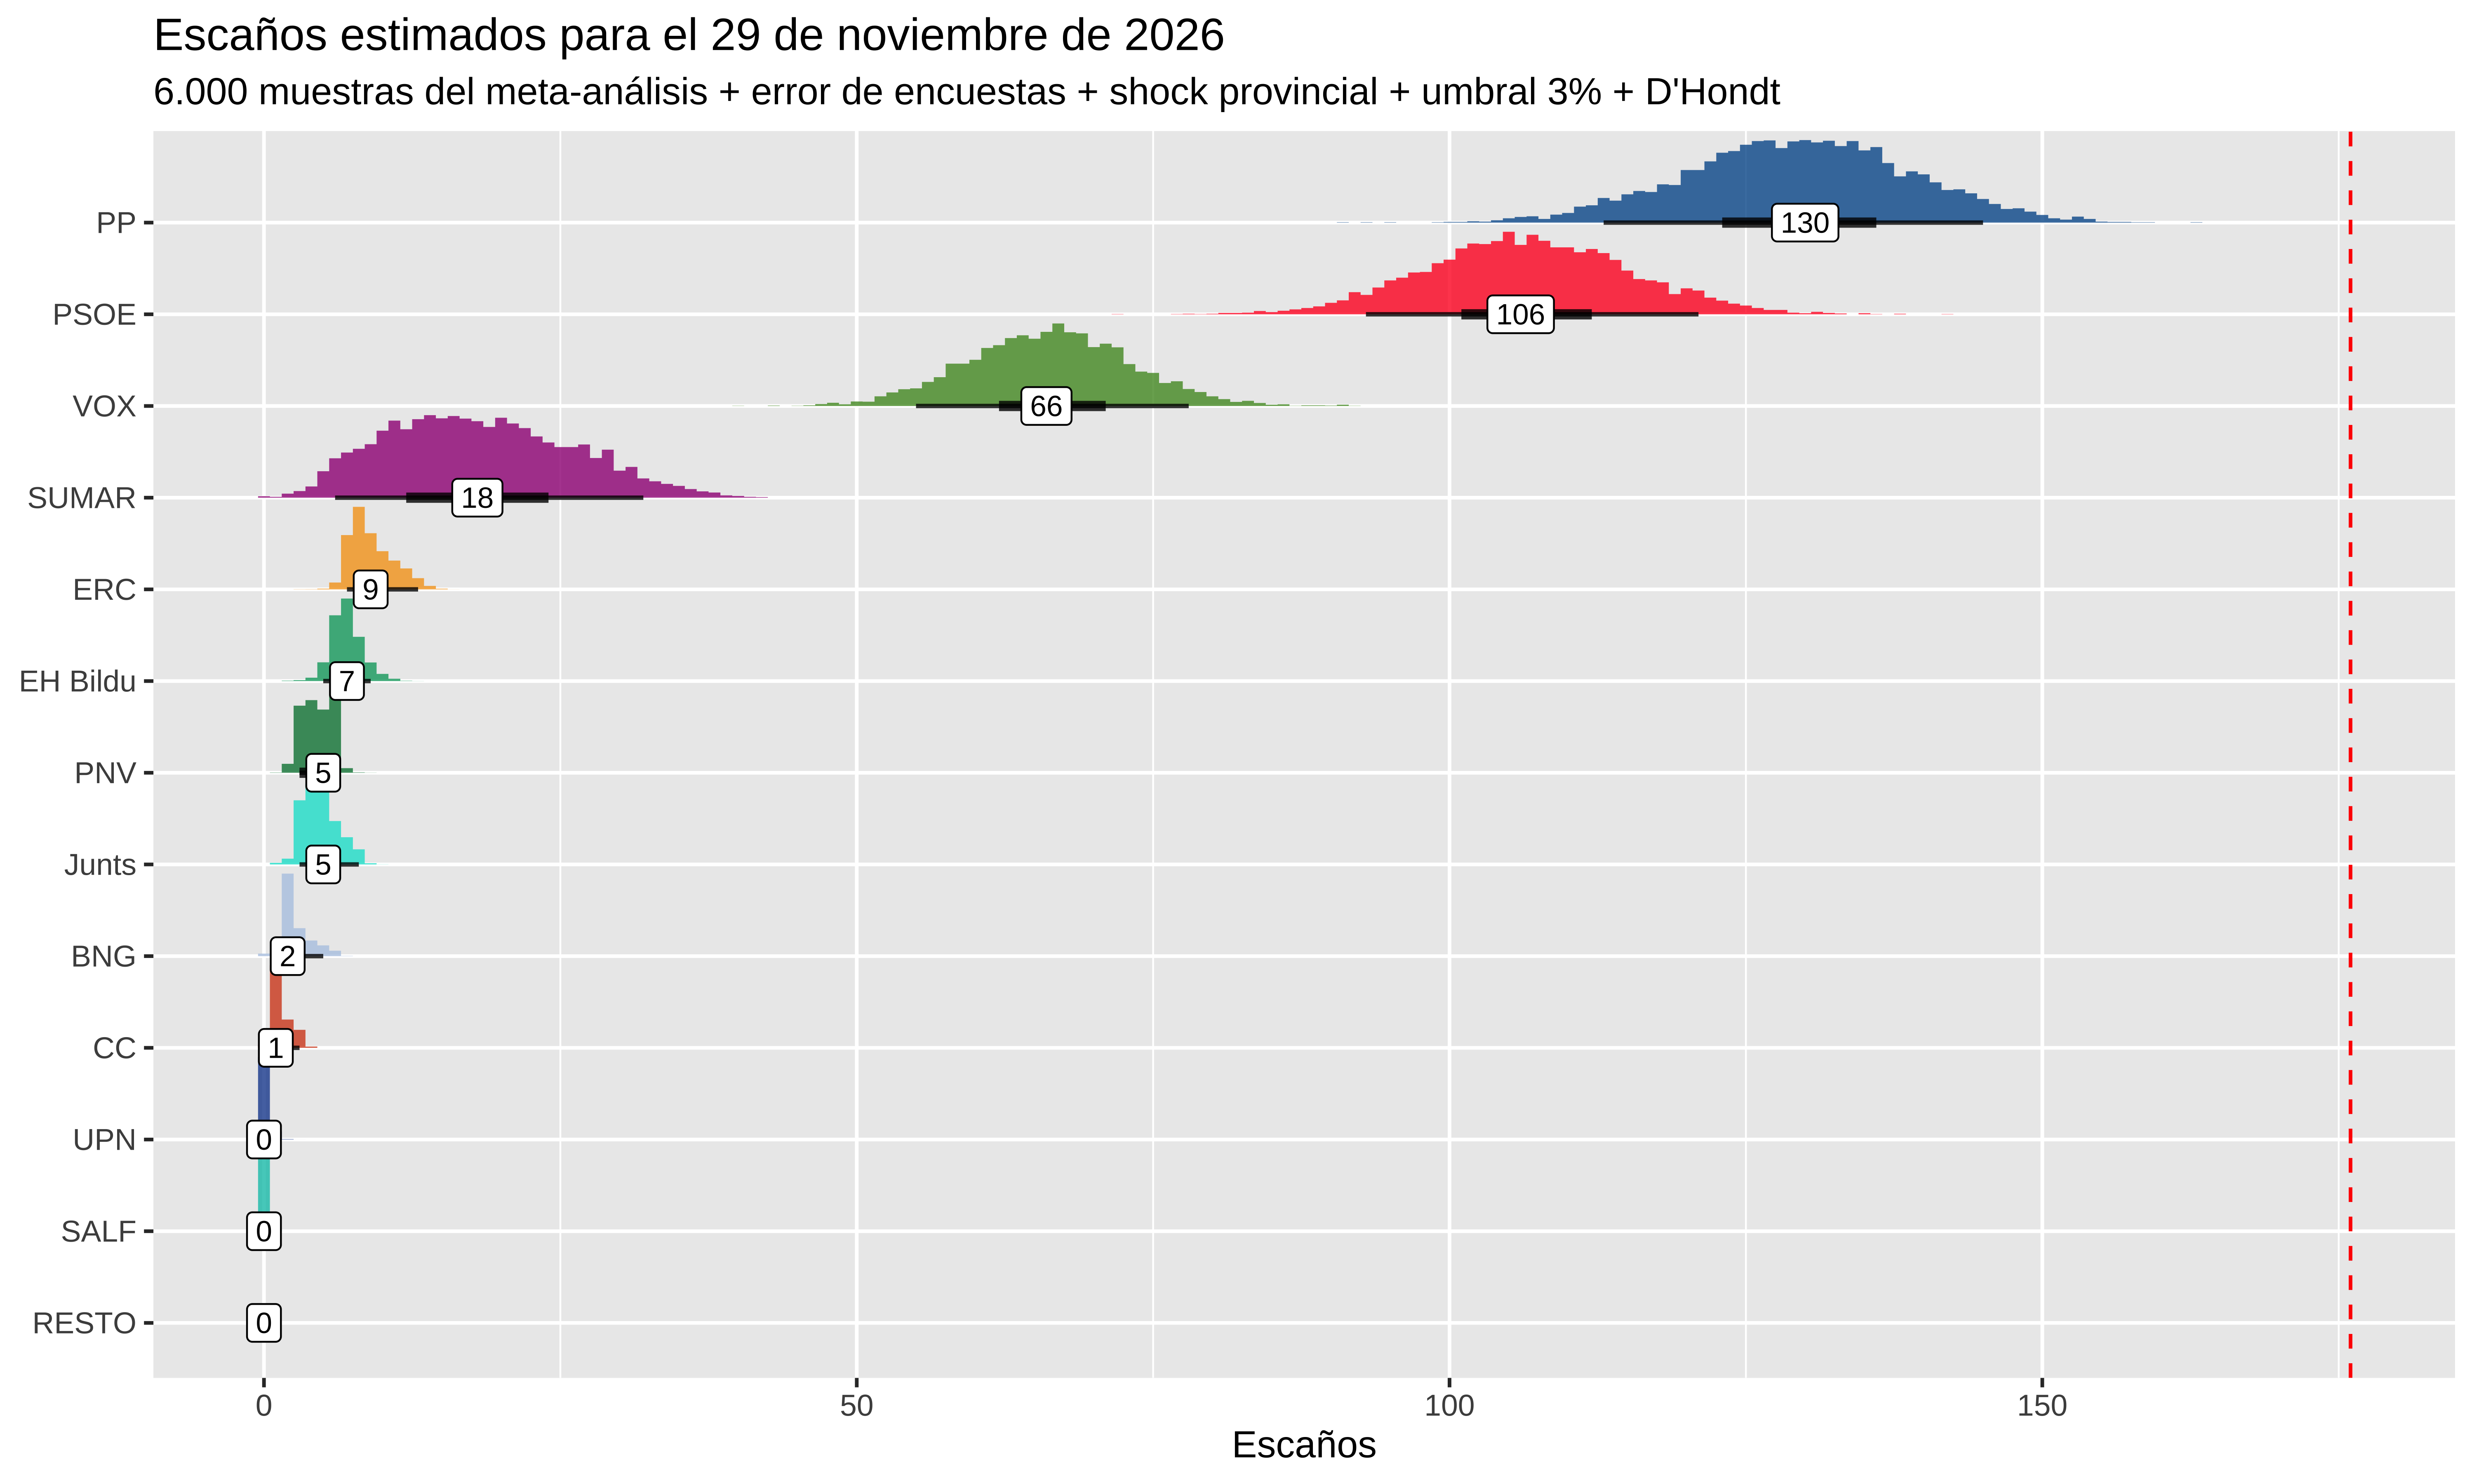
#> 13 RESTO 0 0Vamos ya con la simulación final. La función simular tiene como argumentos por defecto.
simular(n_draws = 2000, time_obj = time_eleccion, con_ruido = TRUE, modo_ruido = "shock", con_error = TRUE, umbral = 0.03, resto_compite = FALSE, sigma_bloque = 1.5, cor_bloque = 0, t_sigma_df = NULL)
Y lo que hace es: cada muestra del posterior (voto nacional del modelo 1 + composición del bloque del modelo 2) recibe el error histórico de las encuestas, se distribuye por provincias con los dos efectos (comunidad y provincia) de más arriba, se le aplica el umbral del 3% y D’Hondt provincia a provincia. El modo_ruido = "dirichlet" conserva el divisor de 1.000, por si alguien quiere comparar. 6.000 muestras en unos segundos:
# semilla fija: las cifras de la lectura deben ser reproducibles entre renders
set.seed(7382)
sim <- simular(n_draws = 6000)
#> Fuera (sin n publicado): 1 encuestas — InvyMark
#> Fuera (casas_fuera: CIS, ElectoPanel ): 17 encuestas

# IC 90% por partido
resumen_escanos(sim, width = 0.9) |>
  mutate(across(where(is.numeric), \(x) round(x, 1)))
#> # A tibble: 13 × 7
#>    partido  escanos .lower .upper .width .point .interval
#>    <chr>      <dbl>  <dbl>  <dbl>  <dbl> <chr>  <chr>
#>  1 PP           130  113      145    0.9 median qi
#>  2 PSOE         106   92.9    121    0.9 median qi
#>  3 VOX           66   55       78    0.9 median qi
#>  4 SUMAR         18    6       32    0.9 median qi
#>  5 ERC            9    7       13    0.9 median qi
#>  6 EH Bildu       7    5        9    0.9 median qi
#>  7 Junts          5    3        8    0.9 median qi
#>  8 PNV            5    3        6    0.9 median qi
#>  9 BNG            2    1        5    0.9 median qi
#> 10 CC             1    1        3    0.9 median qi
#> 11 RESTO          0    0        0    0.9 median qi
#> 12 SALF           0    0        0    0.9 median qi
#> 13 UPN 0 0 1 0.9 median qicolores_esc <- c(
"PP" = "#005999",
"PSOE" = "#FF0126",
"VOX" = "#51962A",
"SUMAR" = "#A00B85",
"ERC" = "#F5A21D",
"Junts" = "#00E0D1",
"EH Bildu" = "#00A56D",
"PNV" = "#008141",
"BNG" = "#B5C9E4",
"CC" = "#D44A20",
"UPN" = "#1B4A9B",
"SALF" = "#00C3B6",
"RESTO" = "grey70"
)
sim$draws |>
pivot_longer(-.draw, names_to = "partido", values_to = "escanos") |>
ggplot(aes(x = escanos, y = fct_reorder(partido, escanos), fill = partido)) +
# escaños: enteros con muchos empates; el histograma evita el warning del
# bandwidth (bw.SJ no encuentra escala en muestras tan discretas) y es más
# honesto con datos de conteo. normalize = "groups" escala cada partido a su
# fila: sin él, la altura se normaliza con la densidad máxima global (SALF,
# con rango 0-1) y los partidos grandes quedan invisibles
stat_halfeye(
density = "histogram",
# bins alineados con los enteros: sin esto, bins no enteros dejan huecos
# y "dientes" que no son del reparto D'Hondt sino del histograma
breaks = ggdist::breaks_fixed(width = 1),
align = ggdist::align_center(at = 0),
normalize = "groups",
.width = c(0.5, 0.9),
alpha = 0.8
) +
# etiqueta con la mediana de cada partido
stat_summary(
fun = median,
geom = "label",
aes(label = after_stat(x), fill = NULL),
size = 3,
fill = "white"
) +
scale_fill_manual(values = colores_esc, guide = "none") +
geom_vline(xintercept = 176, linetype = "dashed", color = "red") +
labs(
title = "Escaños estimados para el 29 de noviembre de 2026",
subtitle = "6.000 muestras del meta-análisis + error de encuestas + shock provincial + umbral 3% + D'Hondt",
x = "Escaños",
y = NULL
)
prob_mayorias(sim) |>
  mutate(prob = scales::percent(prob, accuracy = 0.1))
#> # A tibble: 3 × 2
#>   escenario        prob
#>   <chr>            <chr>
#> 1 PP solo >= 176   0.0%
#> 2 PP + VOX >= 176  97.7%
#> 3 izquierda >= 176 1.8%

# valores para el texto (se recalculan en cada render)
p_derecha <- prob_mayorias(sim) |>
  filter(escenario == "PP + VOX >= 176") |>
  pull(prob)
p_izquierda <- prob_mayorias(sim) |>
  filter(escenario == "izquierda >= 176") |>
  pull(prob)
mediana_derecha <- median(sim$draws$PP + sim$draws$VOX)
gap_pp <- 176 - median(sim$draws$PP)
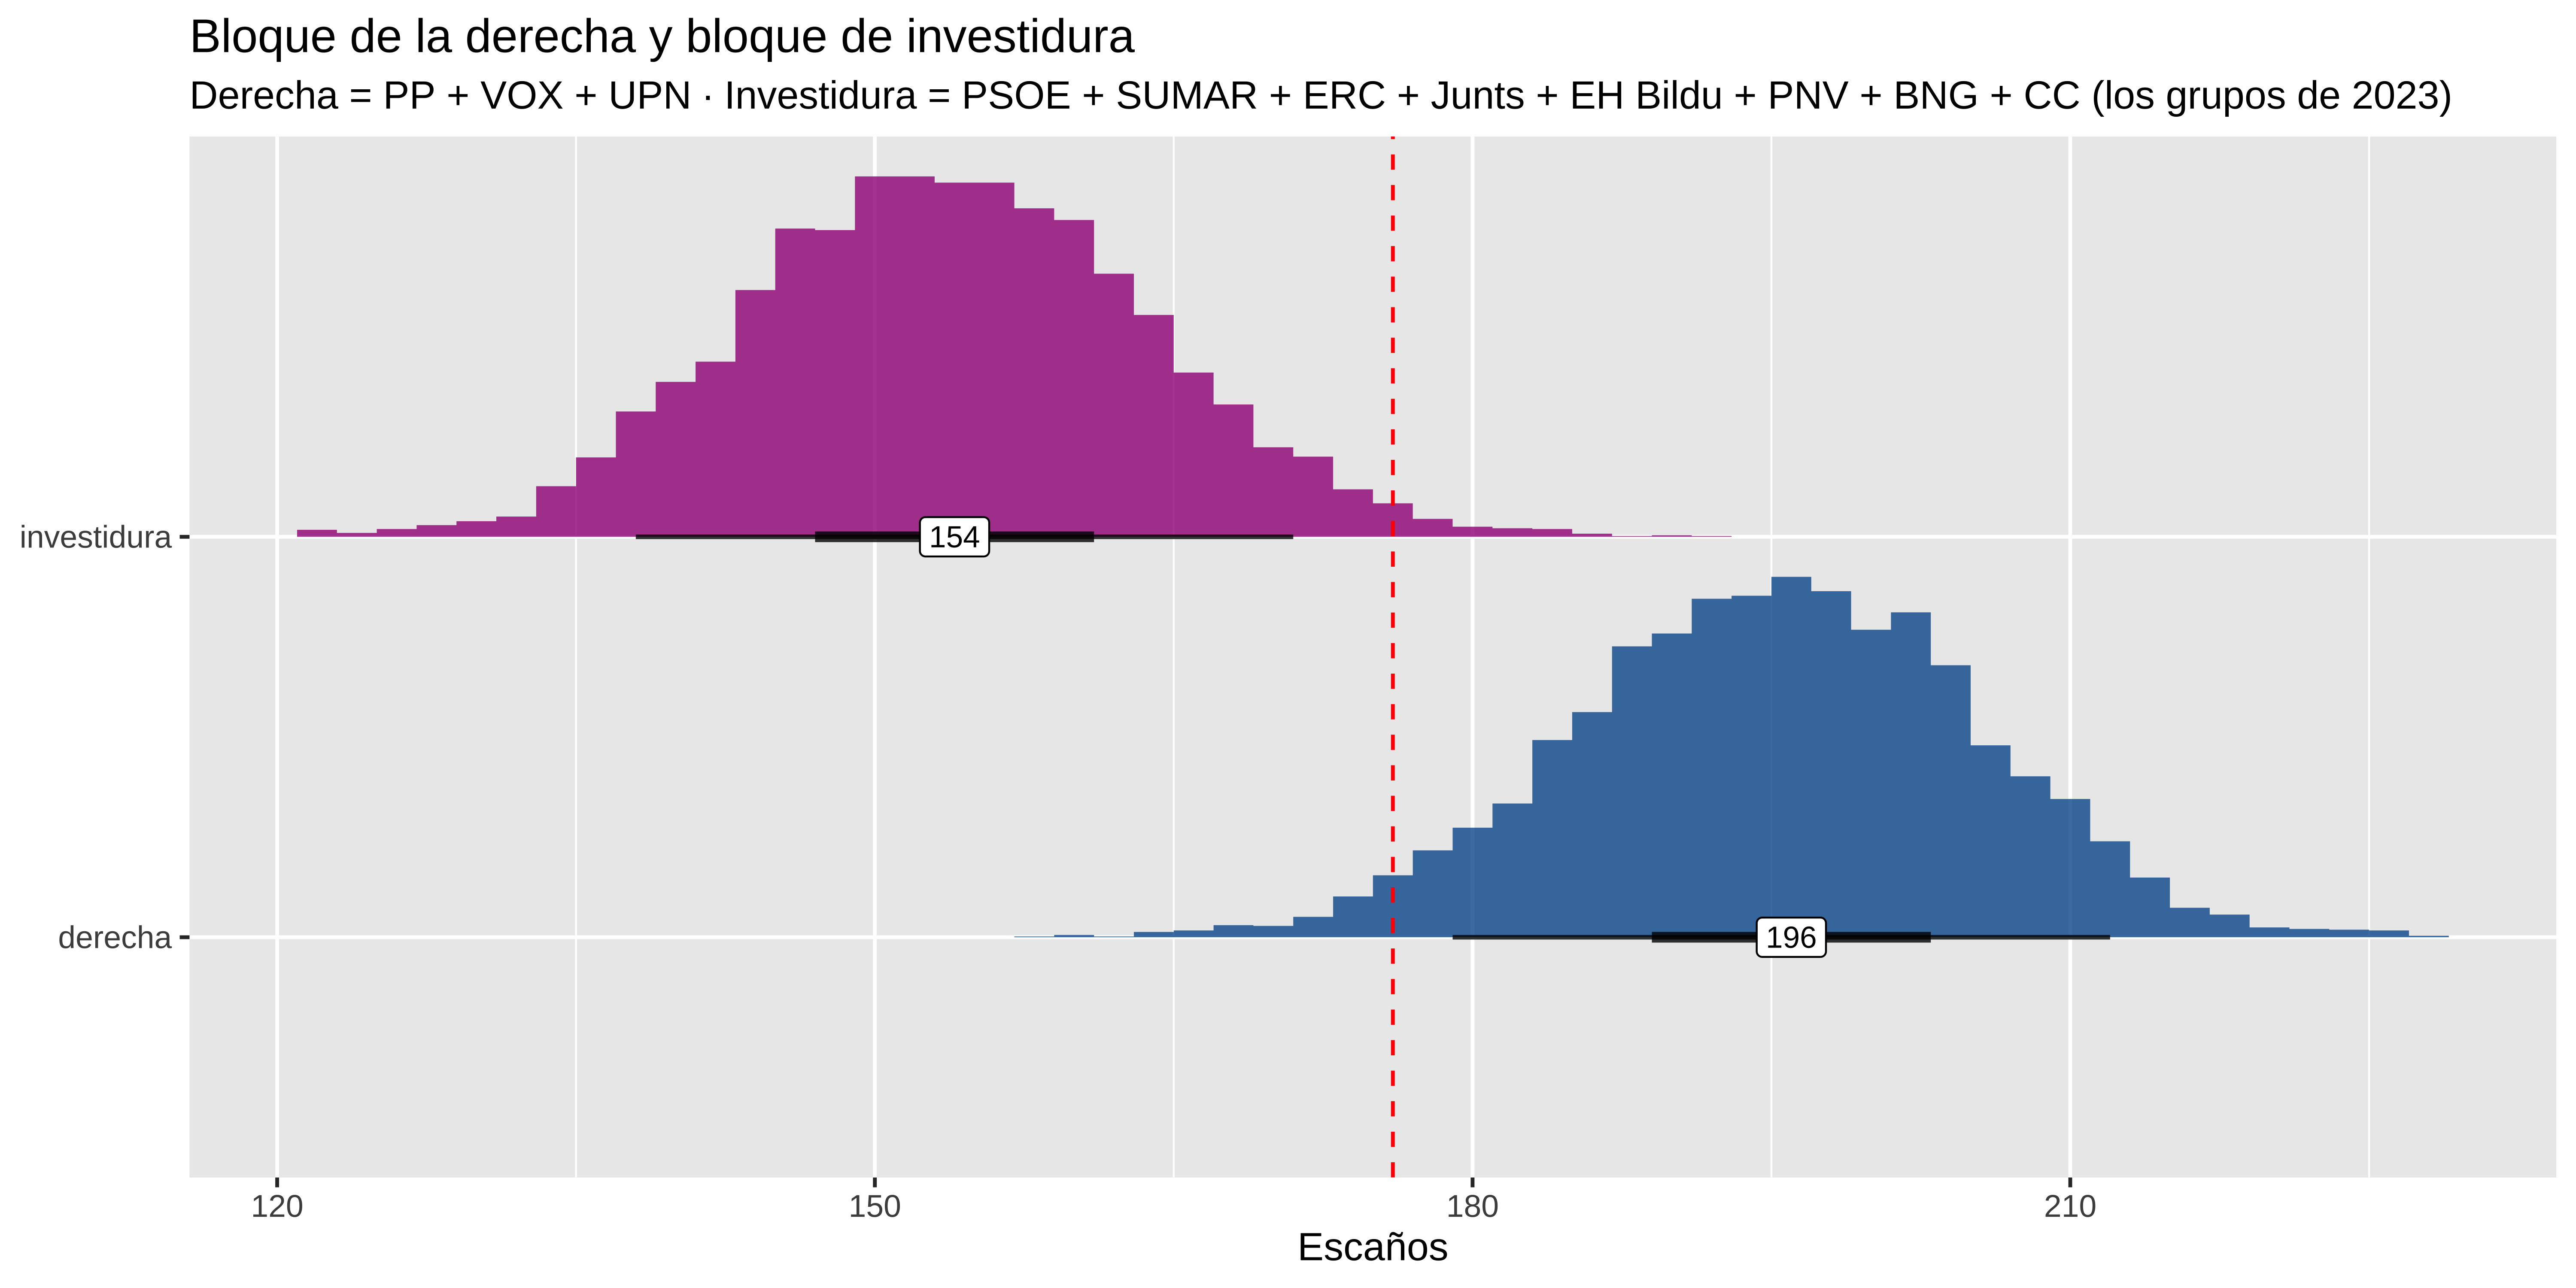
La lectura: con las encuestas con trabajo de campo desde julio, PP + Vox tendrían la mayoría con probabilidad 97,7% (mediana de 196 escaños para la suma) y el PP solo se queda a 46 escaños de la mayoría.
Es la capa de error histórico la que baja esa probabilidad del ~100% que daban los posteriors a secas: si las encuestas se vuelven a equivocar como en las últimas cinco elecciones, el margen ya no sobra. Nada de esto es una predicción: es una fotografía de lo que dicen las encuestas disponibles, con toda la incertidumbre que el modelo es capaz de cuantificar y que iremos añadiendo encuestas entre ahora y el día E.
simular() trae interruptores para apagar cada capa (con_error para el error histórico, con_ruido y modo_ruido para el ruido provincial, que por defecto son los dos efectos y traen la Dirichlet jubilada de vuelta si se les llama), así que se puede medir cuánto aporta cada una. Cinco escenarios, 4.000 muestras cada uno, mirando siempre PP + VOX:
# res_var se calcula en el chunk oculto de la sección del error histórico
res_var |>
  mutate(
    # el porcentaje primero: si el across redondeara antes, un 98.9% pasaría
    # por round(…, 1) = 1 y saldría un "100.0%" falso
    p_mayoria = scales::percent(p_mayoria, 0.1),
    across(where(is.numeric), \(x) round(x, 1))
  )
#> # A tibble: 5 × 5
#>   escenario                         mediana    sd ic90_ancho p_mayoria
#>   <chr>                               <dbl> <dbl>      <dbl> <chr>
#> 1 solo posteriors                       198   4.6         16 100.0%
#> 2 + error histórico                     197   9.3         30 99.2%
#> 3 + shock provincial                    198   5.5         17 100.0%
#> 4 + Dirichlet provincial (jubilada)     199   5.3         18 100.0%
#> 5 todo (lo del post)                    196   9.8         32 98.0%
La capa de error histórico es, con diferencia, la que más ensancha todo: la desviación típica de PP + VOX se dobla (de 4,6 a 9,3 escaños) y el IC90 pasa de 16 a 30. El ruido provincial por sí solo aporta bastante menos: con el shock, el IC90 va de 16 a 17; con la Dirichlet jubilada, de 16 a 18. Puede parecer poco, y lo es, aunque el shock mueva el voto provincial el triple: el ruido independiente se cancela entre provincias al sumarlas, y lo que no se cancela, el componente de comunidad, es pequeño frente a la capa de error nacional. Encima del error histórico, el shock suma 2 escaños al IC90 (30 → 32). Dos lecturas más: la mediana baja de 198 a 197, que es la corrección al PSOE cobrándose escaños a la derecha, y la probabilidad de mayoría apenas se mueve (del 100,0% de los posteriors a secas al 98,0% con todas las capas, la fila «todo» de la tabla; la diferencia con el 97,7% de la lectura final es ruido de Monte Carlo: aquí 4.000 muestras, allí 6.000). Con las encuestas de julio-octubre el colchón sobre los 176 es de 20 escaños, y lo que la capa de error hace sobre todo es avisar de que ese colchón puede quedarse en la mitad.
Un apunte sobre esa capa dominante: sus σ salen de solo 5 elecciones y están estimados con ruido (el IC95 de una sd con n = 5 va de 0,6× a 2,9× el valor estimado) y la versión plug-in los trata como si se conocieran con exactitud. Si en cada muestra se muestrea el propio σ de su posterior (lo mismo que pedirle al error una t de Student con 4 gl, colas más gordas) el IC90 de PP + VOX pasa de ~33 a ~41 escaños y la probabilidad de mayoría de la derecha baja del ~98% al ~95%. Los σ̂ son estables entre elecciones (lo de arriba) y el backtest de más abajo va por ahí: con t₄ su cobertura se va al 100% con IC90 de ~33 escaños (cubre de más), mientras el plug-in se queda en un 83-94%, compatible con el 90% nominal. Así que t₄ vive en simular(t_sigma_df = 4) como sensibilidad, no como default.
En la validación de como hubiera salido en el 23J lo que se comprueba es que el mecanismo de asignar escaños funciona, dadas unas proporciones por partido en cada provincia. Pero para ver si el modelo predice bien, una forma de hacerlo es irte a elecciones pasadas, ver las encuestas y aplicar el mismo mecanismo que hemos hecho, es decir, estimar el % de voto provincial con la asunción de que los ratios de reparto por partido en cada provincia son similares a las elecciones anteriores de las que se quiere estimar.
Para eso he hecho un backtest (backtest_pipeline.R). En el script se usa al igual que antes la fantástica librería infoelectoral
La idea es sencilla. Para cada una de las cinco últimas generales me pongo en el día de la votación y hago lo que habría hecho entonces, solo con lo que se sabía en ese momento:
errores_encuestas_historicas.csv. Son 12 en el 20D, 2 en el 26J (campaña corta) y 20, 30 y 60 en el resto.Umbral del 3% y D’Hondt, como en producción.
# el backtest completo (baja 10 elecciones de infoelectoral y corre 2.000
# muestras por elección) vive en backtest_pipeline.R; aquí leo sus salidas
# congeladas. Configuración: geografía de la elección anterior, mu encogido
# a la mitad, semilla fija en el script
esc_bt <- read_csv(
  here::here("2026/10/backtest_escanos.csv"),
  show_col_types = FALSE
)
vot_bt <- read_csv(
  here::here("2026/10/backtest_votos.csv"),
  show_col_types = FALSE
)

# para las cifras en línea del texto
peor_esc <- esc_bt |>
  mutate(e = abs(mediana - real)) |>
  slice_max(e, n = 1)

bind_rows(
  vot_bt |> mutate(tipo = "voto"),
  esc_bt |> mutate(tipo = "escaños")
) |>
  group_by(tipo) |>
  summarise(
    celdas = n(),
    cobertura = mean(dentro),
    ancho_medio_ic90 = mean(q95 - q05),
    error_mediano = median(abs(mediana - real))
  ) |>
  mutate(across(where(is.numeric), \(x) round(x, 2)))
#> # A tibble: 2 × 5
#>   tipo    celdas cobertura ancho_medio_ic90 error_mediano
#>   <chr>    <dbl>     <dbl>            <dbl>         <dbl>
#> 1 escaños     18      0.94            26.0           7
#> 2 voto        18      0.83             5.51          1.27
¿Qué sale? Pues bastante bien:
read_csv(
  here::here("2026/10/backtest_resumen.csv"),
  show_col_types = FALSE
) |>
  filter(tipo == "P(derecha)") |>
  select(
    Elección = eleccion,
    Encuestas = n_encuestas,
    `PP+VOX real` = real_derecha,
    `P(PP+VOX >= 176)` = p_derecha_176
  ) |>
  mutate(`P(PP+VOX >= 176)` = scales::percent(`P(PP+VOX >= 176)`, 0.1))
#> # A tibble: 5 × 4
#>   Elección Encuestas `PP+VOX real` `P(PP+VOX >= 176)`
#>   <chr>        <dbl>         <dbl> <chr>
#> 1 20d             12           121 0.0%
#> 2 26j              2           135 0.0%
#> 3 28a             20            90 0.0%
#> 4 10n             30           141 0.0%
#> 5 23j             60           170 0.0%
Ojo, esto es sólo un ejercicio de que más o menos la maquinaria funciona, que dados porcentajes nacionales de voto (en las encuestas), el mecanismo de asignar a provincias, tomando prestada la distribución de las anteriores elecciones y la asignación de escaños, funciona. Eso no asegura que las encuestas actuales acierten, pueden pasar cientos de cosas.
El bloque de investidura de 2023 (los grupos que apoyaron a Sánchez) contra la derecha: si las encuestas no se mueven, la repetición de la aritmética de la anterior legislatura no llega.
Si pensáis en otras alianzas, simplemente hay que cambiar las sumas aquí, o si al final se presenta el frente amplio habría que sumar los porcentajes de voto antes de hacer el modelo 1, además, que puede haber un efecto sinérgico de que al ir unidos aumente su % de voto más que simplemente sumar el de cada partido por separado. Si al final se presentan conjuntamente, las encuestas subsiguientes podrían recoger ese efecto.
bloques(sim$draws) |>
  mutate(
    # aquí la derecha lleva a UPN: es el bloque con el que gobernaría, y UPN
    # (1 escaño) se integra con el PP en Navarra
    derecha = PP + VOX + UPN,
    investidura = PSOE + SUMAR + ERC + Junts + `EH Bildu` + PNV + BNG + CC
  ) |>
  select(.draw, derecha, investidura) |>
  pivot_longer(-.draw, names_to = "bloque", values_to = "escanos") |>
  mutate(bloque = fct_relevel(bloque, "derecha", "investidura")) |>
  ggplot(aes(x = escanos, y = bloque, fill = bloque)) +
  stat_halfeye(
    density = "histogram",
    breaks = ggdist::breaks_fixed(width = 2),
    align = ggdist::align_center(at = 0),
    normalize = "groups",
    .width = c(0.5, 0.9),
    alpha = 0.8
  ) +
  # etiqueta con la mediana de cada bloque
  stat_summary(
    fun = median,
    geom = "label",
    aes(label = after_stat(x), fill = NULL),
    size = 3,
    fill = "white"
  ) +
  scale_fill_manual(
    values = c(derecha = "#005999", investidura = "#A00B85"),
    guide = "none"
  ) +
  geom_vline(xintercept = 176, linetype = "dashed", color = "red") +
  labs(
    title = "Bloque de la derecha y bloque de investidura",
    subtitle = "Derecha = PP + VOX + UPN · Investidura = PSOE + SUMAR + ERC + Junts + EH Bildu + PNV + BNG + CC (los grupos de 2023)",
    x = "Escaños",
    y = NULL
  )
simular() y es el default: los 4 grandes con los τ del posterior de brms, los regionales con τ en dos etapas (tau_regionales.csv; solo ERC y Junts tienen señal de bloque, y UPN la hereda), SALF con el RMS de los cuatro grandes y RESTO sin shock. Los totales de escaños apenas se mueven respecto a la Dirichlet jubilada: manda la capa de error nacional y el ruido provincial se cancela al sumar provincias. Lo que cambia de verdad es el reparto provincial.preparar_todo(actualizar = TRUE) → ajustar_grande(refit = TRUE) → simular(), y la baseline de este post queda guardada para medir cuánto se mueve todo.Feliz día.