---
title: "MRP con varias encuestas (II): el modelo, de las provincias a los escaños"
date: '2026-10-30'
date-modified: today
draft: false
categories:
- "2026"
- estadística
- encuestas electorales
- MRP
- R
description: 'MRP con las encuestas del 29-N, segunda parte: por qué el escaño se decide en la provincia, cómo entra en el modelo una encuesta sin provincia y un partido que solo se pregunta en parte del país, y por qué esto pide escribir la verosimilitud a mano.'
execute:
message: false
warning: false
echo: true
format:
html:
toc: true
fig-height: 5
fig-dpi: 300
fig-width: 8
fig-align: center
code-fold: true
code-summary: "Mostrar código"
code-tools:
source: true
toggle: true
knitr:
opts_chunk:
out.width: 80%
fig.showtext: TRUE
collapse: true
comment: "#>"
---
::: callout-note
## Listening
<iframe data-testid="embed-iframe" style="border-radius:12px" src="https://open.spotify.com/embed/track/734dz1YaFITwawPpM25fSt?utm_source=generator&si=e146ad74bd104a12" width="100%" height="352" frameBorder="0" allowfullscreen="" allow="autoplay; clipboard-write; encrypted-media; fullscreen; picture-in-picture" loading="lazy">
</iframe>
:::
## Introducción
En [la primera parte](https://muestrear-no-es-pecado.es/2026/11/mrp-multiencuesta/)
unimos nueve encuestas de cuatro casas (CIS, 40dB, More in Common y Ateneo del
Dato), armonizamos sus variables y fabricamos con raking la tabla de
postestratificación: provincia × sexo × edad × estudios × recuerdo del 23-J,
calibrada con el Censo y los resultados del 23-J por municipio.
El Congreso tiene 350 escaños repartidos entre 52 circunscripciones
provinciales (RD 806/2026: Madrid gana un escaño, Cádiz pierde uno). D'Hondt
trabaja con el **porcentaje de voto provincial**: quien quiere escaños tiene
que estimar voto por provincia, no nacional.
Cuando una empresa encuestadora o el CIS da estimaciones de escaños a partir
de su estimación de voto, lo que se suele hacer es utilizar un método de
proyección de escaños, partiendo de los porcentajes nacionales o, si acaso, a
nivel de CCAA. Para eso se tiene en cuenta cómo fue el reparto provincial en
elecciones anteriores; ya lo conté en el
[post de todo bayesiano](https://muestrear-no-es-pecado.es/2026/10/full-bayesian/full-bayesian.html). La
razón es sencilla: la mayoría de las encuestadoras no tiene suficientes
entrevistas por provincia, y algunas ni siquiera informan de la provincia del
entrevistado, se quedan en la CCAA.
Pero, ¿y si juntamos varios microdatos de encuestas para tener más
entrevistados en las provincias pequeñas? Y no solo eso: ¿y la combinación
Ceuta, estudios altos, de 30 a 34 años y que en 2023 votó al PSOE? Lo normal es
que, incluso tras juntar microdatos, tengas muy pocos entrevistados en esa
combinación, puede que ninguno.
Un modelo MRP, Multilevel Regression and Poststratification, pretende resolver
varios de estos problemas:
- el **multinivel** es lo que permite estimar en celdas pequeñas: utiliza toda
la información disponible y mezcla, con partial pooling, la información
particular y la general;
- la **postestratificación** corrige que la muestra no se parezca a la
población, al menos en las variables por las que postestratificas;
- hacer el modelo de forma **bayesiana** da la incertidumbre del modelo
entera (la posterior, no un error estándar asintótico), y D'Hondt sobre
1.000 draws la convierte en distribución de escaños.
Juntar encuestas, eso sí, trae sus propios problemas. En este post van tres, y
cada uno añade una pieza al modelo:
1. **Celdas casi vacías**: incluso con nueve encuestas, la mayoría de las
combinaciones tiene una entrevista o ninguna.
2. **Dos encuestas sin provincia**: More in Common y Ateneo del Dato solo dan
la CCAA.
3. **Una variable respuesta que cambia según la encuesta**: no todas preguntan por los mismos
partidos.
Y con eso ya se pueden sacar escaños.
```{r setup}
suppressPackageStartupMessages({
  library(dplyr)
  library(tidyr)
  library(gt)
  library(ggplot2)
})

dir_proy <- here::here("2026/11/mrp-multiencuesta")
dir_datos <- file.path(dir_proy, "datos")
read_csv_here <- function(f) read.csv(file.path(dir_proy, f))
num <- function(x, d = 0) format(round(x, d), big.mark = ".", decimal.mark = ",", nsmall = d)

celdas <- readRDS(file.path(dir_datos, "celdas_brms.rds"))
provincias <- readRDS(file.path(dir_datos, "estim_escanos_mrp.rds"))$prov_ref |>
  transmute(prov = as.character(as.integer(codigo_provincia)), provincia)
```
## Problema 1: celdas casi vacías
Los datos que usa esta parte (las celdas de las encuestas, la tabla de
postestratificación y los fits) están en
[la release del post](https://github.com/joscani/blog_quarto/releases/tag/mrp-multiencuesta-datos),
por si quieres reproducirlo sin reajustar nada.
Empecemos por los datos. Las nueve encuestas juntas suman
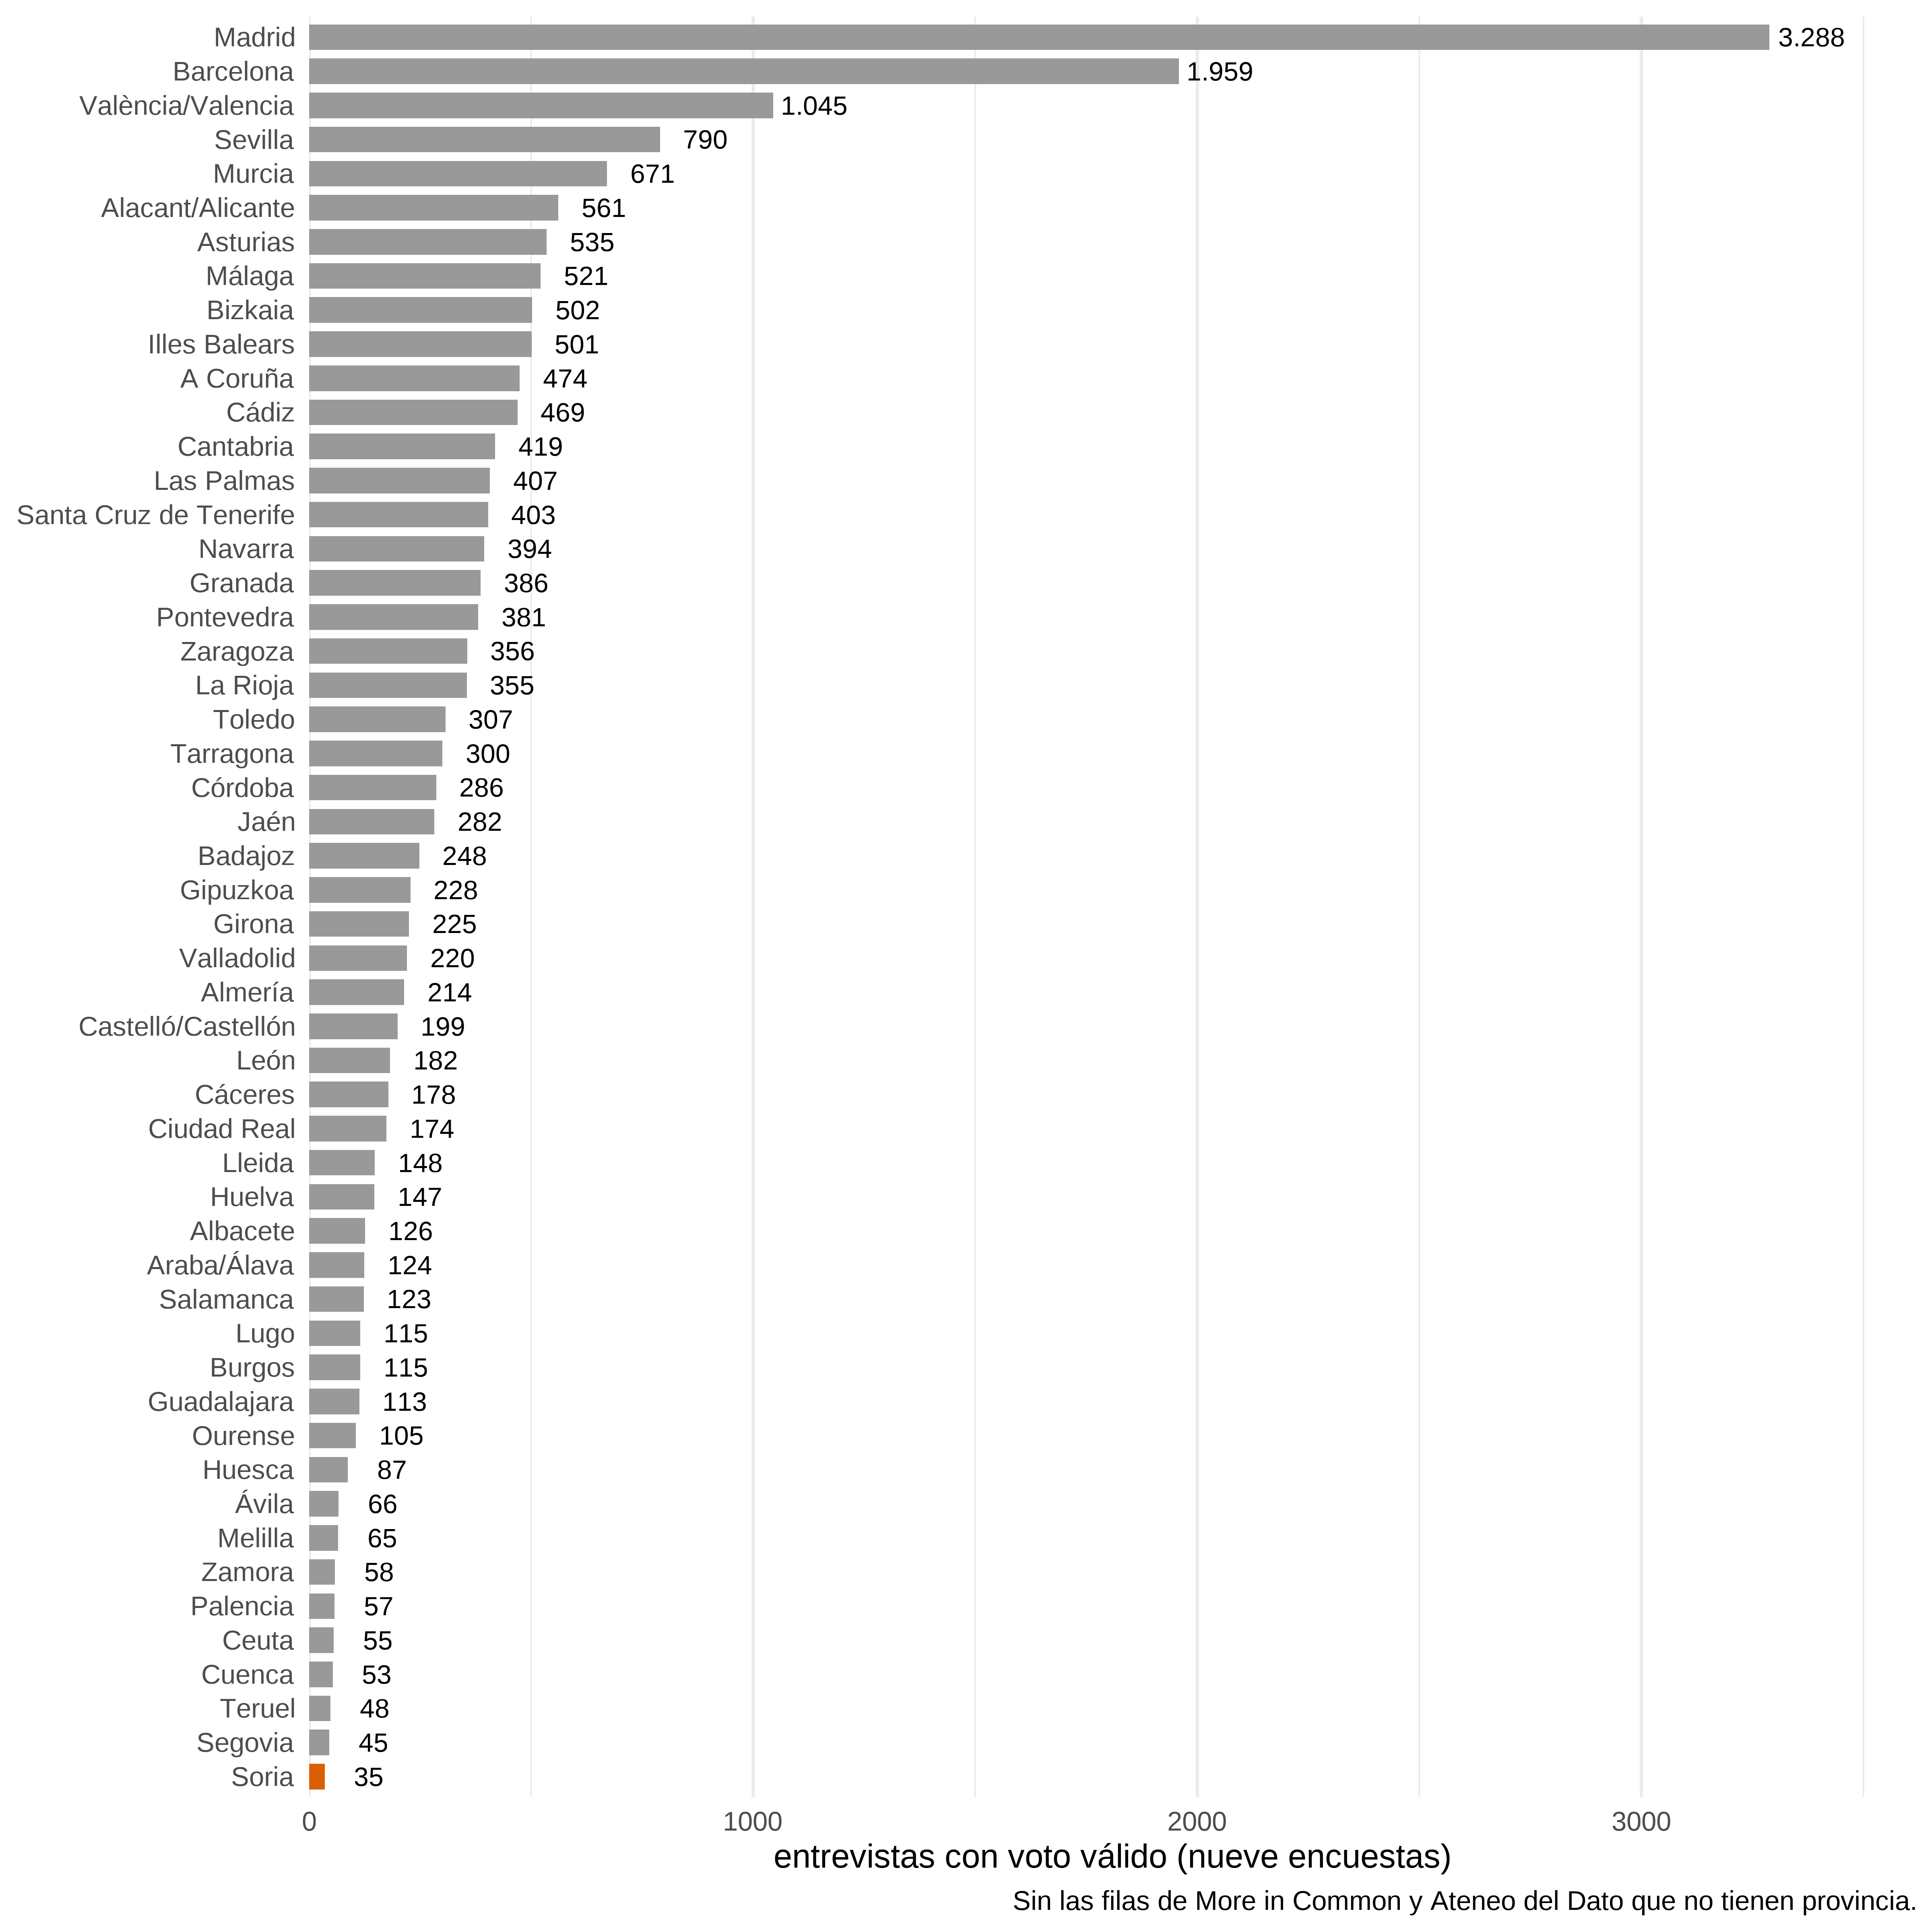
`r num(sum(celdas$n))` entrevistas con intención de voto válida. Pero el escaño se decide en la provincia, así que miremos cuántas
caen en cada una:
```{r prov-n}
#| fig-height: 8
n_prov <- celdas |>
  filter(!is.na(prov)) |>
  summarise(n = sum(n), .by = prov) |>
  mutate(prov = as.character(prov)) |>
  left_join(provincias, by = "prov")
n_soria <- n_prov$n[n_prov$prov == "42"]
n_madrid <- n_prov$n[n_prov$prov == "28"]

ggplot(n_prov, aes(n, reorder(provincia, n))) +
  geom_col(aes(fill = prov == "42"), width = 0.75, show.legend = FALSE) +
  geom_text(aes(label = num(n)), hjust = -0.15, size = 2.8) +
  scale_fill_manual(values = c(`FALSE` = "grey60", `TRUE` = "#d95f02")) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.1))) +
  labs(
    x = "entrevistas con voto válido (nueve encuestas)", y = NULL,
    caption = "Sin las filas de More in Common y Ateneo del Dato que no tienen provincia."
  ) +
  theme_minimal(base_size = 10) +
  theme(panel.grid.major.y = element_blank())
```
Madrid tiene `r num(n_madrid)`; Soria, `r n_soria`. Y para el modelo Soria no
es una provincia, son muchas combinaciones: sexo × edad × estudios × recuerdo del 23-J.
Así se reparten esas `r n_soria` entrevistas entre el recuerdo y la edad, y
eso antes de partir además por sexo y estudios:
```{r soria}
soria <- celdas |> filter(prov == "42")
tabla_pob <- readRDS(file.path(dir_datos, "tabla_post_prov.rds"))
pob_soria <- tabla_pob["42", , , , ]
# recuerdos con población en Soria (ERC, PNV... no existen allí)
rec_soria <- names(which(apply(pob_soria, "rec", sum) > 0))

soria |>
  summarise(n = sum(n), .by = c(rec, edad)) |>
  mutate(rec = as.character(rec)) |>
  complete(rec = rec_soria, edad) |>
  mutate(rec = factor(rec, levels = rec_soria)) |>
  pivot_wider(names_from = edad, values_from = n, names_sort = TRUE) |>
  arrange(rec) |>
  mutate(rec = as.character(rec)) |>
  gt(rowname_col = "rec") |>
  sub_missing(missing_text = "·") |>
  tab_stubhead("recuerdo 23-J") |>
  tab_caption("Entrevistas de Soria por recuerdo y edad (nueve encuestas). Un punto: ninguna.")
```
La población, en cambio, no tiene esos huecos. La misma tabla con los
`r num(sum(pob_soria))` habitantes de Soria que asigna la postestratificación,
por recuerdo y edad:
```{r soria-pob}
pob_rec_edad <- as.data.frame(pob_soria, responseName = "N") |>
  as_tibble() |>
  summarise(N = sum(N), .by = c(rec, edad)) |>
  filter(rec %in% rec_soria) |>
  mutate(rec = factor(rec, levels = rec_soria)) |>
  complete(rec, edad) |>
  pivot_wider(names_from = edad, values_from = N, names_sort = TRUE) |>
  arrange(rec) |>
  mutate(
    across(-rec, ~ ifelse(.x == 0, NA, num(.x))),
    rec = as.character(rec)
  )

pob_rec_edad |>
  gt(rowname_col = "rec") |>
  sub_missing(missing_text = "·") |>
  tab_stubhead("recuerdo 23-J") |>
  tab_caption("Población de Soria por recuerdo y edad (tabla de postestratificación). Un punto: nadie.")
```
Dos detalles de la tabla de población: los que en 2023 no podían votar solo
pueden estar en la fila `NO_PODIA` (y de hecho su población está toda en la
columna 18-20), y no hay filas para ERC, JUNTS o PNV porque en Soria no tienen
población: por eso el modelo ni se plantea repartirles escaños allí.
```{r}
soria_celdas <- soria |> summarise(n = sum(n), .by = c(sexo, edad, edu, rec))
n_celdas_soria <- sum(pob_soria > 0)
n_celdas_total <- sum(tabla_pob > 0)

# celdas con población y sin ninguna entrevista con provincia, en toda España
claves_celda <- c("prov", "sexo", "edad", "edu", "rec")
con_datos <- celdas |>
  filter(!is.na(prov)) |>
  distinct(across(all_of(claves_celda))) |>
  mutate(across(everything(), as.character), con_datos = TRUE)
n_celdas_vacias <- as.data.frame.table(tabla_pob, responseName = "N") |>
  filter(N > 0) |>
  mutate(across(all_of(claves_celda), as.character)) |>
  left_join(con_datos, by = claves_celda) |>
  summarise(sum(is.na(con_datos))) |>
  pull()
```
En la tabla de postestratificación Soria tiene `r n_celdas_soria` celdas con
población. De ellas, `r nrow(soria_celdas)` tienen alguna entrevista y
`r sum(soria_celdas$n == 1)` solo una. Las otras
`r n_celdas_soria - nrow(soria_celdas)` están vacías. En toda España son
`r num(n_celdas_total)` celdas, y Soria no es la excepción: es lo normal en
cuanto sales de Madrid, Barcelona y Valencia.
En estos casos la proporción cruda, un group by y una media, no tiene
sentido, y un modelo que trate cada factor por su lado tampoco es capaz de
aprovechar toda la información. Como siempre dice Carlos, quien no tiene en
cuenta la estructura palma pasta. Y aquí hay estructura: el efecto de haber
votado a VOX no es el mismo en Andalucía que en Cataluña (eso sí lo meto en el
modelo, CCAA × recuerdo), y lo que se sabe de la edad, los estudios o la
provincia en unas celdas sirve para las demás.
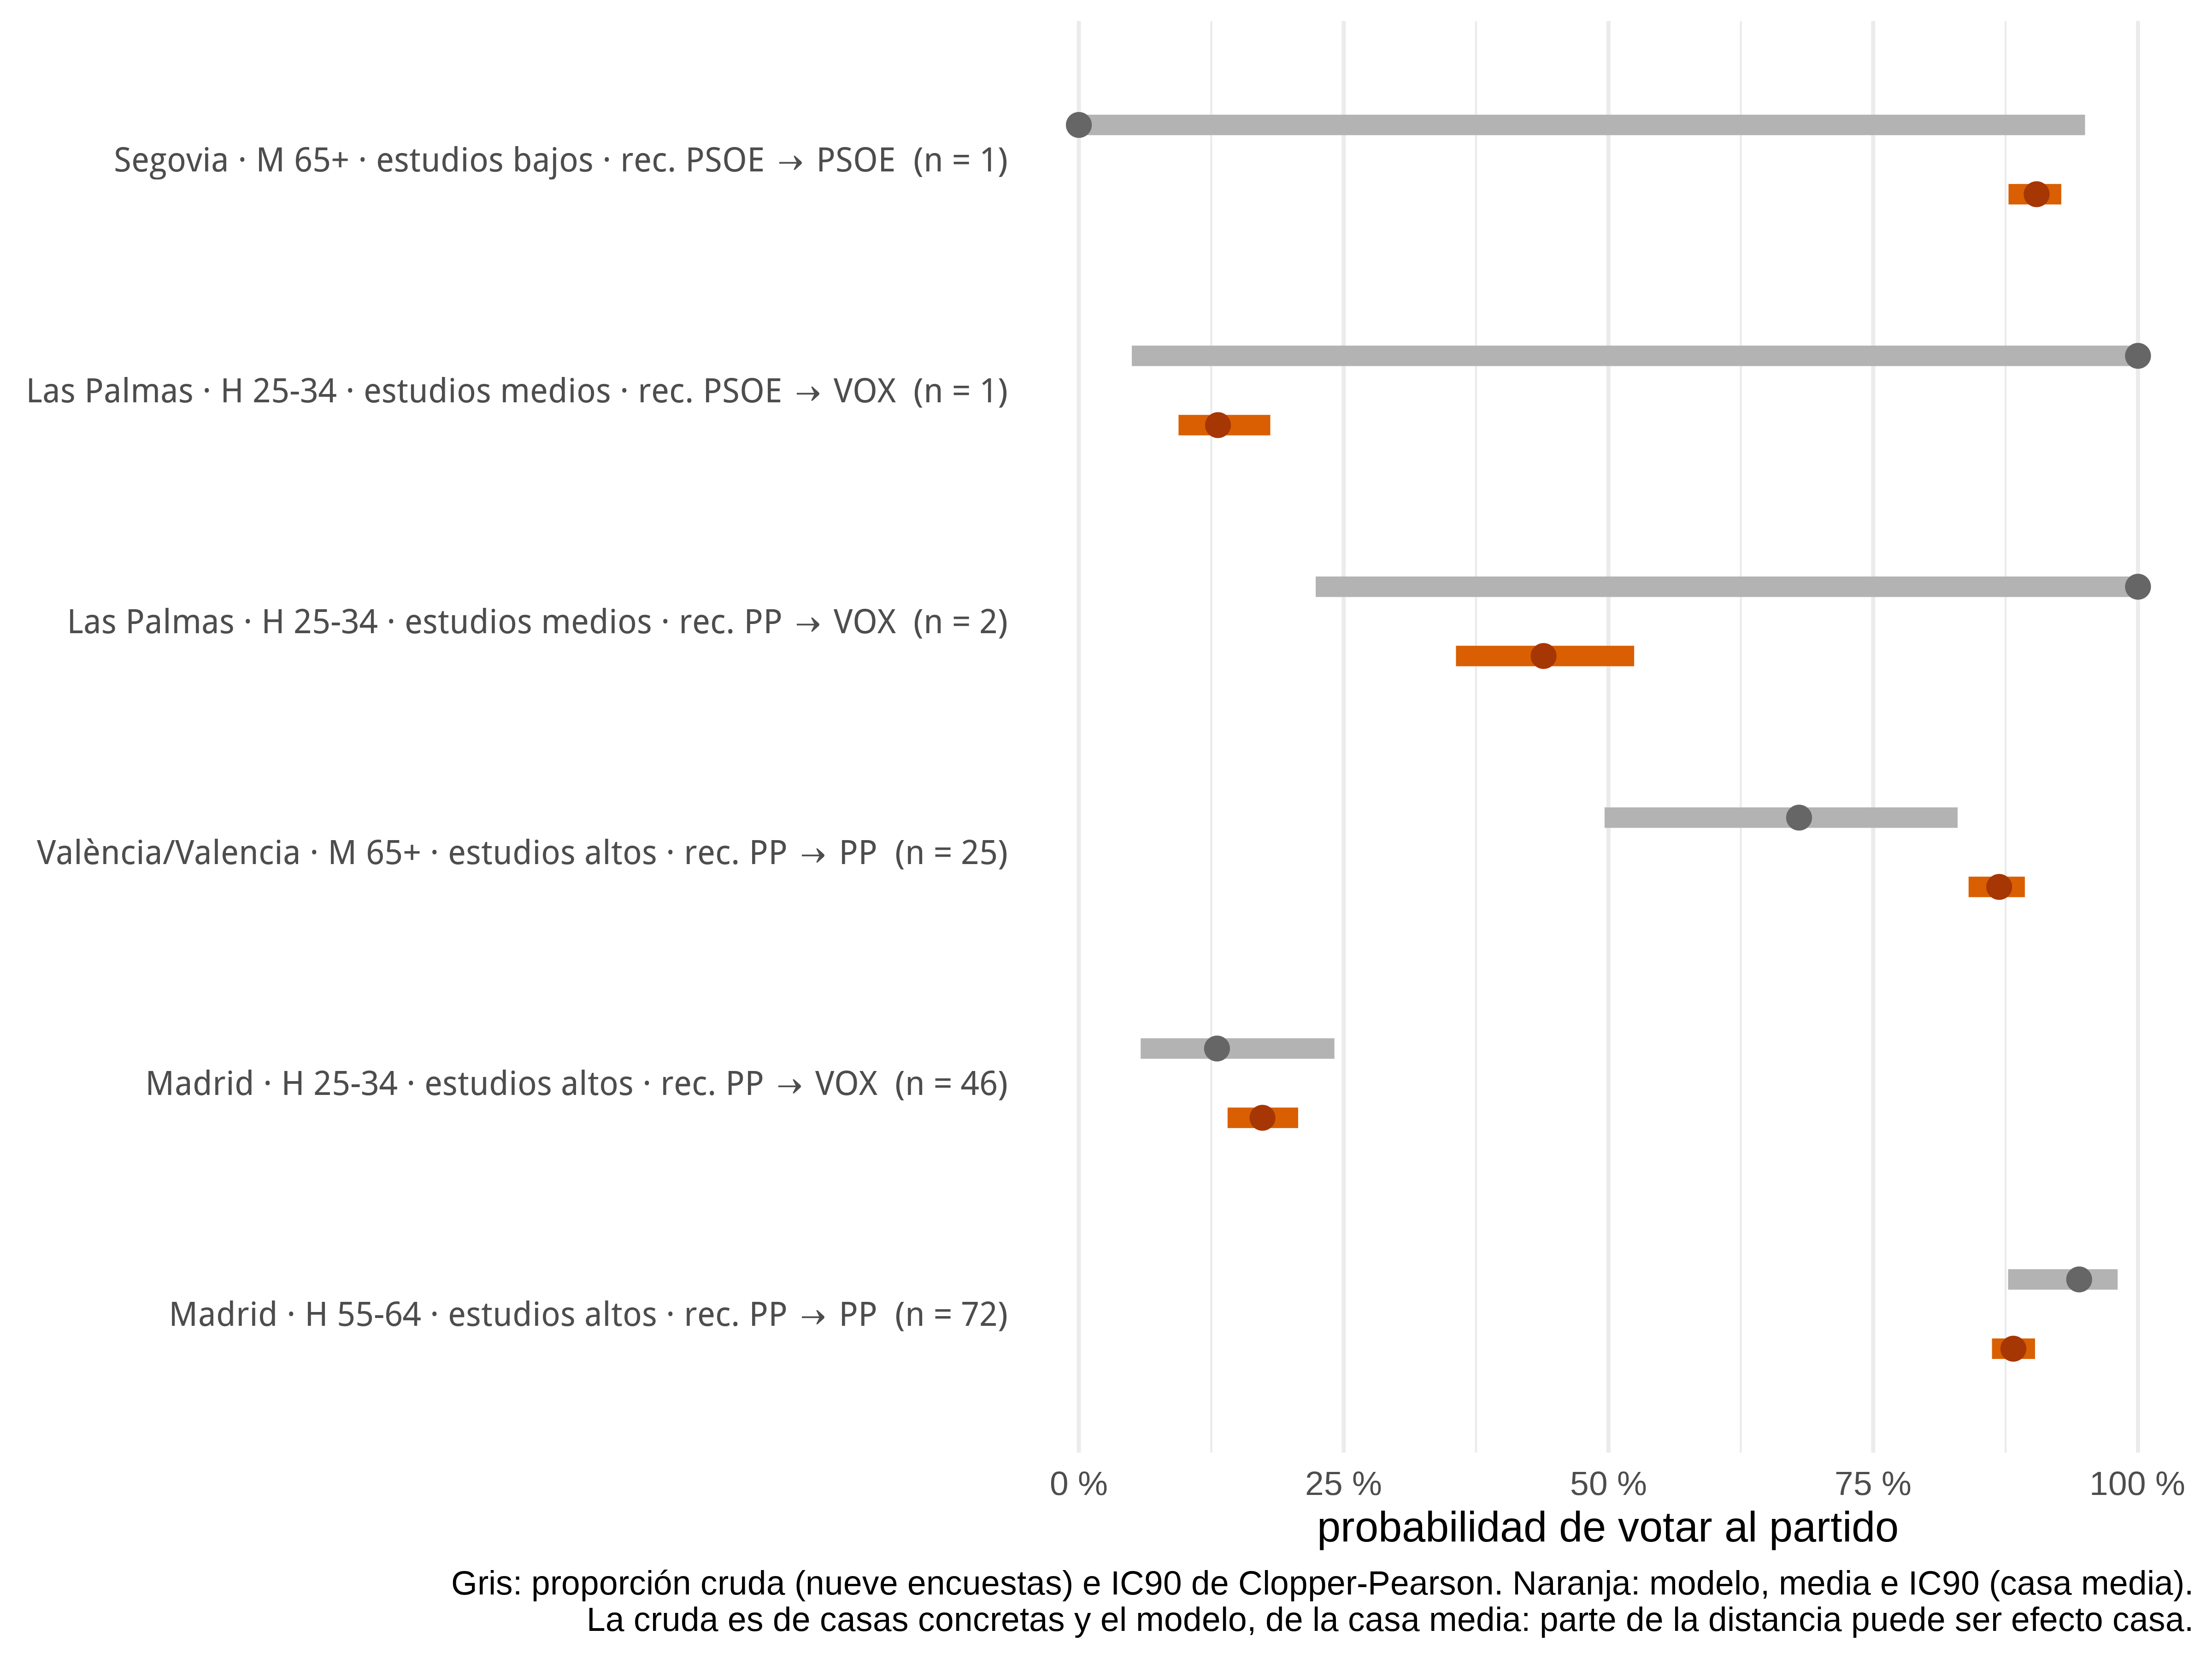
Dos ejemplos reales del ajuste:
- **Las Palmas, hombre de 25-34, estudios medios, recuerda votar PP.** El CIS
tiene 2 entrevistas en la celda y las dos dicen que votarían a VOX: bruto
100 %. El modelo hace algo distinto: de los datos ha aprendido que los
hombres jóvenes votan más a VOX, y también que en Canarias eso no se da con
tanta fuerza. Junta lo que ha aprendido de lo general con lo particular,
hombre joven, votó a PP en las últimas, es de Canarias, y a ese perfil de
votante le da una probabilidad de votar a VOX del 43,9 % [35,6, 52,4]. En
cambio, al mismo perfil, misma edad y estudios, dice que va a votar a VOX,
pero que recuerda haber votado a PSOE, le da un 13,1 %.
- **Segovia, mujer de 65+, estudios bajos, recuerda votar PSOE.** La única
entrevista de este perfil dice que no vota al PSOE: bruto 0 %; el modelo,
sin embargo, le da 90,4 % [87,8, 92,8]. La fidelidad de las socialistas
mayores pesa más que una entrevista.
Ese salto entre lo bruto y lo que dice un modelo pasa siempre, sea o no
multinivel. La diferencia fundamental del multinivel es que combina mejor la
información particular y la general, y que incluso puede dar inferencias a
combinaciones no vistas en los datos.
## Problema 2: encuestas sin provincia
Hasta aquí, todo eso supone que sé de qué provincia es cada entrevistado.
Pues no siempre. More in Common y Ateneo del Dato **no preguntan
la provincia**, solo dan la Comunidad Autónoma.
```{r sin-prov}
sin_prov <- celdas |>
  filter(casa %in% c("More in Common", "Ateneo del Dato")) |>
  mutate(provincia = if_else(is.na(prov), "sin provincia", "con provincia")) |>
  summarise(n = sum(n), .by = c(ccaa, casa, provincia))
n_sin_prov <- sum(sin_prov$n[sin_prov$provincia == "sin provincia"])

sin_prov |>
  pivot_wider(names_from = casa, values_from = n, values_fill = 0) |>
  arrange(provincia, desc(`More in Common`)) |>
  mutate(ccaa = as.character(ccaa)) |>
  gt(rowname_col = "ccaa", groupname_col = "provincia") |>
  tab_caption("Entrevistas con voto válido de More in Common y Ateneo del Dato, por CCAA.")
```
Son `r num(n_sin_prov)` entrevistas sin provincia, un
`r num(100 * n_sin_prov / sum(celdas$n))` % del total, en Andalucía, Cataluña,
la Comunitat Valenciana… justo las CCAA con más escaños.
¿Qué habría hecho normalmente? Eliminar esas filas y quedarme solo con las que venía informada la provincia.
Pero Virgilio siempre dice que el bayesiano es más flexible, así que me puse a investigar si se podía aprovechar esa info.
De hecho, un entrevistado de More in Common en Castilla y León dice algo sobre el
voto en Castilla y León, aunque no sepamos de qué provincia es.
### `brms` con `mm()`
En el [post de raking](https://muestrear-no-es-pecado.es/2026/10/mrp-raking/)
usé `brms` y fue bien con una encuesta, `brms` es fácil de escribir, y al final genera código en Stan sin que te
des cuenta, compila y muestrea.
Tiene algo que se parece mucho a lo que hace falta, el [multi-membership](https://paulbuerkner.com/brms/reference/mm.html), que asigna a cada fila sin provincia una mezcla de efectos de provincia, a la fórmula del modelo
```r
(1 | mm(p1, p2, ..., p9, weights = cbind(w1, w2, ..., w9)))
```
con w1 = 1 en la provincia propia para las encuestas que la tienen, y cuando solo informa de la comunidad autónoma, se ponen pesos (w) a cada provincia según lo que representan en la población, esto se saca de las tablas de población que usamos en el post anterior, o de la tabla con la distribución conjunta.
`mm()` promedia en la escala del logit,
$\mathrm{softmax}(\sum_p w_p\, \eta_p)$, pero lo matemáticamente correcto es la
mezcla de probabilidades, $\sum_p w_p \cdot \mathrm{softmax}(\eta_p)$.
La fórmula completa del primer intento era esta (esquema: el script la
construye pegando cadenas, ver
[`05_brms_mm.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/05_brms_mm.R);
hay un `mu<partido>` por cada partido menos PP, la referencia, cada uno con sus
propios efectos aleatorios y sus propias sd, sin compartir nada entre partidos,
y los territoriales añaden la máscara de offset):
```r
f_comun <- sexo + (1 | casa) + (1 | edad) + (1 | edu) + (1 | rec) +
  (1 | ccaa) + (1 | ccaa:rec) + (1 | casa:rec) + (1 | mes) +
  (1 | mm(p1, p2, ..., p9, weights = cbind(w1, w2, ..., w9), scale = FALSE))

bf(
  y | trials(n) ~ f_comun,   # PP, el partido de referencia
  muPSOE ~ f_comun,
  muVOX ~ f_comun,
  muSUMAR ~ f_comun,
  ...                        # muPODEMOS, muJUNTS, ..., muOTROS
  muERC ~ f_comun + offset(off_ERC),  # territoriales: -20 fuera de su CCAA
  ...,
  family = multinomial()
)
```
Se ve con un caso real. En Canarias, More in Common no dice si el entrevistado
es de Las Palmas o de Santa Cruz de Tenerife, y Coalición Canaria no pesa lo mismo en las dos.
Con los resultados del 23-J:
```{r juguete-mm}
softmax <- function(x) exp(x) / sum(exp(x))
mun <- readRDS(file.path(dir_datos, "mun_23j.rds")) |>
filter(codigo_provincia %in% c("35", "38"))
validos <- mun |>
distinct(codigo_provincia, codigo_municipio, votos_candidaturas, votos_blancos) |>
group_by(codigo_provincia) |>
summarise(validos = sum(votos_candidaturas + votos_blancos))
canarias <- mun |>
mutate(g = case_when(
siglas == "CCa" ~ "CC",
siglas %in% c("PP", "PSOE") ~ "PP+PSOE",
TRUE ~ "resto"
)) |>
group_by(codigo_provincia, g) |>
summarise(votos = sum(votos), .groups = "drop") |>
left_join(validos, by = "codigo_provincia") |>
pivot_wider(names_from = g, values_from = votos) |>
mutate(resto = validos - CC - `PP+PSOE`, w = validos / sum(validos))
canarias
```
Si ahora hacemos la suma ponderada tanto en escala logit (la incorrecta) como la ponderada en escala de probabilidades (la correcta), vemos que difieren:
```{r}
p <- as.matrix(canarias[, c("CC", "PP+PSOE", "resto")]) / canarias$validos
w <- canarias$w
rbind(
`Las Palmas` = p[1, ],
`S. C. de Tenerife` = p[2, ],
`mezcla de probabilidades` = colSums(w * p),
`softmax del logit medio (mm)` = softmax(colSums(w * log(p)))
) |>
(\(x) round(100 * x, 1))()
```
Supongamos un votante de More in Common en Canarias, la encuesta no informa
de la provincia, pero sí de la CCAA. Su probabilidad (real, latente) de
votar a CC es la media ponderada de las dos provincias, con el peso de cada
una dentro de Canarias: un 11,3 %, entre el 6,3 % de Las Palmas y el 16,6 %
de Tenerife.
La versión que hace `mm` en brms da un 10,4 %, que no se
corresponde. El promedio de logits tira hacia la provincia donde el partido
es pequeño. Aquí es un punto, pero en las celdas (combinaciones de sexo, edad, nivel de estudios, recuerdo de voto) las provincias se
separan más que en el agregado y la diferencia puede ser mayor.
### Factorizando en Stan
La forma correcta sale de la ley de la probabilidad total. Si no sé la
provincia, la probabilidad de que un entrevistado de la CCAA $c$ vote al
partido $j$ es la suma, provincia a provincia, de la probabilidad de ser de esa
provincia por la de votar a $j$ siendo de ella:
$$
P(j \mid c) = \sum_{p \in c} \underbrace{P(p \mid c)}_{w_p} \cdot
\underbrace{P(j \mid p)}_{\mathrm{softmax}(\eta_p)_j} .
$$
Los pesos $w_p$ salen de la tabla de postestratificación (qué parte de los
hombres de 25-34 con estudios medios y recuerdo PP de Canarias vive en cada
provincia), y las $P(j \mid p)$ son las del propio modelo.
En Stan se escribe tal cual dentro de la verosimilitud: hasta 9 softmax por fila en Castilla y León. La encuesta sin provincia informa de la media de sus provincias, y lo que distingue a Las
Palmas de Tenerife lo aprenden las encuestas que sí tienen provincia. De esta forma se puede aprovechar toda la info disponible y añadirla al modelo de forma transparente.
Los pesos salen de la población, así que asumo que More in Common, dentro de Castilla y León y para un mismo perfil, no tiene más gente de Valladolid de la que le toca. Un panel
online que tire hacia las capitales lo incumpliría. No lo puedo comprobar,
pero es bastante menos inventado que asignarle una provincia a cada uno.
## Problema 3: no todos los partidos están en todas partes
### Partidos que solo compiten en su territorio
ERC solo se presenta en Cataluña, UPN solo en Navarra, el PNV en el País
Vasco, el BNG en Galicia, etc. Mirando en los datos de las encuestas:
```{r regionales}
reg <- c("ERC", "JUNTS", "BILDU", "PNV", "BNG", "CCA", "UPN")
celdas |>
  summarise(across(all_of(reg), sum), .by = ccaa) |>
  pivot_longer(-ccaa, names_to = "partido", values_to = "n") |>
  filter(n > 0) |>
  summarise(
    `CCAA con menciones` = paste(ccaa, collapse = ", "),
    menciones = sum(n),
    .by = partido
  ) |>
  gt() |>
  tab_caption("Menciones de los partidos regionales en las nueve encuestas.")
```
Fuera de su territorio, sus ceros son **estructurales**: nadie vota a ERC en
Soria porque en Soria no se puede votar a ERC. Si el modelo no lo sabe, tiene
que explicar esos ceros con efectos de CCAA y provincia muy negativos, que es
gastar estructura en algo que ya sabemos, y además le deja a ERC una
probabilidad pequeña, pero no nula, en Soria.
La solución es un poco compadre, pero efectiva: fuera
de su territorio la probabilidad de cada regional se fija a cero (en el
predictor lineal entra un offset de $-20$, que en probabilidad es cero a
efectos prácticos). Y en la postestratificación lo pongo a cero exacto con una
máscara, que ya vimos en el post de raking que el $-20$ a veces no basta.
En el [post de raking](https://muestrear-no-es-pecado.es/2026/10/mrp-raking/) UPN iba fundida en OTROS y eso distorsionaba el quinto
escaño navarro: su ~20 % navarro se repartía mal. Aquí es categoría propia.
### Partidos que no están en todos los cuestionarios
Lo de AA (Adelante Andalucía) es más sutil. AA solo se presenta en Andalucía,
pero además no todas las encuestas la ofrecen como respuesta. Mirando solo
Andalucía:
```{r aa}
celdas |>
  filter(ccaa == "Andalucía") |>
  summarise(entrevistas = sum(n), `menciones de AA` = sum(AA), .by = c(estudio, sin_aa)) |>
  mutate(`¿ofrece AA?` = if_else(sin_aa, "no", "sí")) |>
  arrange(sin_aa, estudio) |>
  select(estudio, `¿ofrece AA?`, entrevistas, `menciones de AA`) |>
  gt() |>
  tab_caption("Andalucía: entrevistas con voto válido y menciones de AA por encuesta.")
```
Las encuestas que ofrecen AA le dan entre un 3 y un 6 % de las menciones en
Andalucía; las que no la ofrecen, cero. Esos ceros son de **diseño del cuestionario**, no
evidencia de que nadie vote a AA. Si el modelo los cuenta como datos, AA queda
aplastada por más de 1.700 entrevistas que no podían elegirla.
Una solución, que no la única, es la multinomial condicionada.
Pongamos que en una celda andaluza el modelo dice PP 35 %, PSOE 28 %, VOX 17 %, AA 5 % y resto 15 %.
Para un entrevistado del CIS, que sí podía elegir AA, la probabilidad de que diga
PSOE es 28 %. Para uno de 40dB de julio, que no podía, es la probabilidad de
decir PSOE *sabiendo que no ha dicho AA*: 28 / 95 = 29,5 %. En general, para
las encuestas sin AA,
$$
P(j \mid \text{no AA}) = \frac{\exp(\eta_j)}{\sum_{k \neq \text{AA}} \exp(\eta_k)} ,
\qquad j \neq \text{AA}.
$$
Así esas encuestas informan sobre el reparto entre los partidos que sí
ofrecían, que es lo que de verdad saben, y no dicen nada sobre AA. AA queda
identificada por las que sí la preguntaban: el CIS y el flash de 40dB. Es la
misma idea de factorizar la verosimilitud que en el post de todo bayesiano,
donde el desglose regional entraba condicionado al total del bloque.
He dicho que era una solución, pero no la única, aquí estamos normalizando en las encuestas que no ofrecían responder Adelante Andalucía, para mezclarlas con las que sí, pero el problema es que quizá el voto a AA estaba dentro de otros. El supuesto que hago aquí me parece débil y debería cambiarlo, pero no me da la vida. Así que voy a asumir que estoy infraestimando el voto de Adelante Andalucía. En el post de meta análisis full bayesian, ya hice unos supuestos en los que quizás lo sobreestimaba, ya que usaba sus resultados en las autonómicas como proxy de lo que podría alcanzar ahora.
Sea como sea, el caso es que en `brms` no hay forma de expresar este tipo de supuestos.
Entre este problema y el anterior, no quedaba otra que escribir la verosimilitud a mano en Stan (también lo hice en numpyro y en RTMB, pero partiendo de la formulación en Stan).
## El modelo
Para cada celda y cada partido $j$, el modelo construye
un predictor lineal sumando efectos:
$$
\begin{aligned}
\eta_j = \; & \alpha_j + \beta_j \cdot \text{mujer}
+ a^{\text{edad}}_j + a^{\text{estudios}}_j + a^{\text{recuerdo}}_j
&& \text{quién es} \\
& + a^{\text{CCAA}}_j + a^{\text{provincia}}_j + a^{\text{CCAA×recuerdo}}_j
&& \text{dónde vive} \\
& + a^{\text{casa}}_j + a^{\text{casa×recuerdo}}_j + a^{\text{mes}}_j
&& \text{quién pregunta y cuándo}
\end{aligned}
$$
y la probabilidad de votar a cada partido es la softmax de los $\eta_j$, sin
partido de referencia.
Cada bloque de efectos $a$ es aleatorio: sus valores salen de una normal con su propia sd, por partido.
Eso es el partial pooling del problema 1: si la provincia de Soria tiene pocos datos, su efecto se queda cerca de 0 salvo que los datos digan otra cosa.
Las dos interacciones son las que importan para MRP: CCAA × recuerdo (la fidelidad del votante del PSOE no es la misma en Andalucía que en Cataluña) y casa × recuerdo (cada casa tiene su
manera de captar a los votantes de cada partido).
Sobre ese predictor van las tres piezas: la mezcla de provincias para las
filas de More in Common, la verosimilitud condicional para las encuestas que
no ofrecían AA, y la máscara de territorio para UPN y los regionales. Todo
está en
[`mrp_voto.stan`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/stan/mrp_voto.stan).
Aparte del modelo de la intención del voto, tengo otro modelo para la participación ([`mrp_part.stan`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/stan/mrp_part.stan)),
binomial, sobre quién dice "10, seguro que voto", con las mismas variables,
efecto casa (sin Ateneo del Dato, que no lo pregunta) y la misma mezcla de
provincias.
La casa media sale en un 60,5 %, muy lejos del 70,4 % de
participación entre residentes del 23-J, así que en cada draw muevo el
intercepto, en escala logit, hasta que cuadre. La hipótesis es que la
participación de 2026 se comporta como la del 23-J: fijo el nivel agregado y
mantengo las diferencias entre perfiles en logit, sumar lo mismo a todos
conserva las distancias entre perfiles. Ese intercepto es una palanca: moverlo,
en vez de anclarlo al 23-J, da escenarios de participación sin tocar nada más;
es lo que exploto en la tercera parte.
Lo ajusto aparte del de voto y emparejo draw con draw, lo que supone que la incertidumbre de uno no tiene que ver con la del otro. Sirve para dar el peso de cada celda en la
postestratificación: cuenta quien vota, no quien está en el censo.
::: {.callout-note collapse="true"}
## Los priors
Los priors de las sd importan más de lo que parece. Con `exponential(1)`, lo
habitual, el prior predictivo era indecente: un 44 % de las celdas tenía un
partido por encima del 90 %. Con `sd_rec ~ N+(0, 2)` (el recuerdo sí puede
mover mucho el voto), `N+(0, 0.5)` para el resto y `N+(0, 0.25)` para las
interacciones, baja a un 22 % de celdas con un partido dominante, que ya es
algo razonable. Los interceptos y los efectos van centrados entre
partidos (`sum_to_zero_vector` en Stan), para que la softmax sin referencia
esté identificada.
:::
### Las celdas, con y sin modelo
La figura sigue a seis celdas, de menos a más entrevistas sumando las nueve
encuestas. En gris, la proporción en bruto con su intervalo binomial; en color, la
estimación del modelo con su IC90. Con una o dos entrevistas el dato bruto no dice
nada (el intervalo va de casi 0 a 100) y el modelo se va adonde dice el resto
de la estructura; según crecen las entrevistas, los dos intervalos se
estrechan y se acercan.
```{r pooling}
#| fig-height: 6
if (!file.exists(file.path(dir_datos, "datos_pooling.rds"))) {
  source(here::here("2026/11/mrp-multiencuesta/07b_pooling_datos.R"))
}
d_pool <- readRDS(file.path(dir_datos, "datos_pooling.rds"))
claves <- c("prov", "sexo", "edad", "edu", "rec")

# en bruto con las nueve encuestas (las filas sin provincia no cuentan)
cruda9 <- celdas |>
  filter(!is.na(prov)) |>
  summarise(across(c(PP, PSOE, VOX, n), sum), .by = all_of(claves)) |>
  pivot_longer(c(PP, PSOE, VOX), names_to = "partido", values_to = "y")

celdas_fig <- tribble(
  ~partido, ~prov, ~sexo, ~edad,   ~edu,    ~rec,
  "PSOE",   "40",  "M",   "65+",   "baja",  "PSOE",
  "VOX",    "35",  "H",   "25-34", "media", "PSOE",
  "VOX",    "35",  "H",   "25-34", "media", "PP",
  "PP",     "46",  "M",   "65+",   "alta",  "PP",
  "VOX",    "28",  "H",   "25-34", "alta",  "PP",
  "PP",     "28",  "H",   "55-64", "alta",  "PP"
)

a_chr <- \(d) mutate(d, across(all_of(claves), as.character))

fig <- celdas_fig |>
  left_join(a_chr(cruda9), by = c("partido", claves)) |>
  left_join(a_chr(d_pool) |> select(all_of(c("partido", claves)), media, q05, q95),
            by = c("partido", claves)) |>
  left_join(provincias, by = "prov") |>
  rowwise() |>
  mutate(
    cp_lo = binom.test(y, n, conf.level = 0.9)$conf.int[1],
    cp_hi = binom.test(y, n, conf.level = 0.9)$conf.int[2]
  ) |>
  ungroup() |>
  mutate(
    estudios = c(baja = "bajos", media = "medios", alta = "altos")[edu],
    etq = sprintf("%s · %s %s · estudios %s · rec. %s → %s  (n = %d)",
                  provincia, sexo, edad, estudios, rec, partido, n),
    etq = reorder(etq, -n)
  )

ggplot(fig, aes(y = etq)) +
  geom_linerange(aes(xmin = 100 * cp_lo, xmax = 100 * cp_hi),
                 color = "grey70", linewidth = 2.5,
                 position = position_nudge(y = 0.15)) +
  geom_point(aes(x = 100 * y / n), color = "grey40", size = 2.5,
             position = position_nudge(y = 0.15)) +
  geom_linerange(aes(xmin = 100 * q05, xmax = 100 * q95),
                 color = "#d95f02", linewidth = 2.5,
                 position = position_nudge(y = -0.15)) +
  geom_point(aes(x = 100 * media), color = "#a63603", size = 2.5,
             position = position_nudge(y = -0.15)) +
  scale_x_continuous(limits = c(0, 100), breaks = seq(0, 100, 25),
                     labels = \(x) paste0(x, " %")) +
  labs(
    x = "probabilidad de votar al partido", y = NULL,
    caption = "Gris: proporción cruda (nueve encuestas) e IC90 de Clopper-Pearson. Naranja: modelo, media e IC90 (casa media).\nLa cruda es de casas concretas y el modelo, de la casa media: parte de la distancia puede ser efecto casa."
  ) +
  theme_minimal() +
  theme(panel.grid.major.y = element_blank())
```
La primera fila es la celda de Segovia de antes: juntando todas las encuestas
solo hay una mujer con ese perfil, y no dice que votará al PSOE, dice que
votará al PP:
```{r primera-celda}
partidos_fig <- c("PP", "PSOE", "VOX", "SUMAR", "BILDU")

celdas |>
  filter(prov == "40", sexo == "M", edad == "65+", edu == "baja", rec == "PSOE") |>
  select(all_of(partidos_fig), n) |>
  pivot_longer(-n, names_to = "partido", values_to = "encuestadas") |>
  left_join(
    d_pool |>
      filter(prov == "40", sexo == "M", edad == "65+", edu == "baja", rec == "PSOE") |>
      select(partido, media),
    by = "partido"
  ) |>
  mutate(
    encuestadas = ifelse(encuestadas == 0, NA, encuestadas),
    modelo = paste0(trimws(num(100 * media, 1)), " %")
  ) |>
  select(partido, encuestadas, modelo) |>
  gt() |>
  sub_missing(missing_text = "·") |>
  cols_label(partido = "partido", encuestadas = "encuestadas", modelo = "el modelo") |>
  tab_caption("La celda de la primera fila de la figura: lo que contesta su única encuestada y lo que estima el modelo. Un punto: nadie la elige.")
```
Con una sola entrevista el modelo no tiene demasiado que aprender de esa celda,
así que pesa mucho más lo que sabe del resto de los datos sobre quienes
recuerdan haber votado al PSOE.
### Cuánto sabe el modelo
El multinivel encoge, y el bayesiano además te dice **cuánto sabe**. El 2/2
de Las Palmas tiene un IC90 de [22 %, 100 %]. Es honesto,
pero no usa nada de lo que sabemos de VOX, de Canarias o de lo fieles que son
los votantes del PP. El modelo dice [35,6, 52,4]: más estrecho porque usa esa
estructura, pero tampoco se cree que tenga mil entrevistas.
En las `r num(n_celdas_vacias)` celdas con población y sin ninguna entrevista
no hay nada que calcular; el modelo predice con lo que sabe del contexto
(para BILDU: alto en Álava y Navarra, casi 0 en el resto). Y esa
incertidumbre no se queda en la celda: cada draw de la posterior lleva su
reparto provincial completo, y D'Hondt, una función discreta y escalonada, lo
convierte en una distribución de escaños. Con draws esa propagación es casi
gratis. También se puede simular de una normal asintótica, que es lo que hace
RTMB más abajo, pero hay que hacerlo a propósito.
Así que con pocas entrevistas el modelo no se vuelve loco, y cuando no sabe,
lo dice en la anchura del intervalo.
## Los escaños
### La postestratificación, con un ejemplo
El modelo da la probabilidad de voto en cada celda; la postestratificación
pondera cada celda con lo que pesa **en la población**, no en la muestra. Para
verlo basta con una sola variable, el recuerdo del 23-J:
```{r postestrat}
if (!file.exists(file.path(dir_datos, "datos_postestrat.rds"))) {
  source(here::here("2026/11/mrp-multiencuesta/07c_postestrat_datos.R"))
}
pe <- readRDS(file.path(dir_datos, "datos_postestrat.rds"))
psoe_mue <- 100 * sum(pe$muestra * pe$p_psoe)
psoe_pob <- 100 * sum(pe$poblacion * pe$p_psoe)
pp_mue <- 100 * sum(pe$muestra * pe$p_pp)
pp_pob <- 100 * sum(pe$poblacion * pe$p_pp)
# el texto dice que el PP pasa por delante al postestratificar
stopifnot(psoe_mue > pp_mue, pp_pob > psoe_pob)

pe |>
  bind_rows(tibble(
    rec = c("voto ponderando con la muestra", "voto ponderando con la población"),
    p_psoe = c(psoe_mue, psoe_pob) / 100,
    p_pp = c(pp_mue, pp_pob) / 100
  )) |>
  mutate(across(-rec, ~ 100 * .x)) |>
  gt(rowname_col = "rec") |>
  tab_stubhead("recuerdo 23-J") |>
  cols_label(
    muestra = "% en la muestra", poblacion = "% en la población",
    p_psoe = "P(PSOE | recuerdo)", p_pp = "P(PP | recuerdo)"
  ) |>
  fmt_number(decimals = 1, dec_mark = ",", sep_mark = ".") |>
  sub_missing(missing_text = "") |>
  tab_style(cell_text(weight = "bold"), cells_body(rows = 8:9)) |>
  tab_style(cell_text(weight = "bold"), cells_stub(rows = 8:9)) |>
  tab_caption("Probabilidades del modelo: casa media y si votara todo el mundo.")
```
La muestra trae un `r num(100 * pe$muestra[pe$rec == "PSOE"], 1)` % de
recuerdo PSOE, cuando en la población es un
`r num(100 * pe$poblacion[pe$rec == "PSOE"], 1)` %, y un
`r num(100 * pe$muestra[pe$rec == "ABST"], 1)` % de abstencionistas del 23-J
frente al `r num(100 * pe$poblacion[pe$rec == "ABST"], 1)` % real. A las
encuestas contesta más quien vota, y o contesta más quien votó al PSOE, o más
gente dice haberlo votado. Con estos datos no puedo separar las dos cosas, y
postestratificar por recuerdo asume que el recuerdo es verdad. Con las mismas
probabilidades del modelo, ponderar con la muestra da al PSOE un
`r num(psoe_mue, 1)` % y al PP un `r num(pp_mue, 1)` %; ponderar con la
población, `r num(psoe_pob, 1)` % y `r num(pp_pob, 1)` %. El PSOE baja
`r num(psoe_mue - psoe_pob, 1)` puntos y el PP pasa por delante, solo por quién
contesta. En el modelo se hace lo mismo, pero con
las `r num(n_celdas_total)` celdas en vez de 7 filas, y draw a draw.
Ojo, que la tabla de población también es fabricada: sale del raking de
[la primera parte](https://muestrear-no-es-pecado.es/2026/11/mrp-multiencuesta/),
donde los totales vienen de fuentes oficiales (el Censo y los resultados del
23-J), pero la semilla, qué variables van juntas dentro de cada provincia, la
ponen las encuestas del CIS.
### De las celdas a los escaños
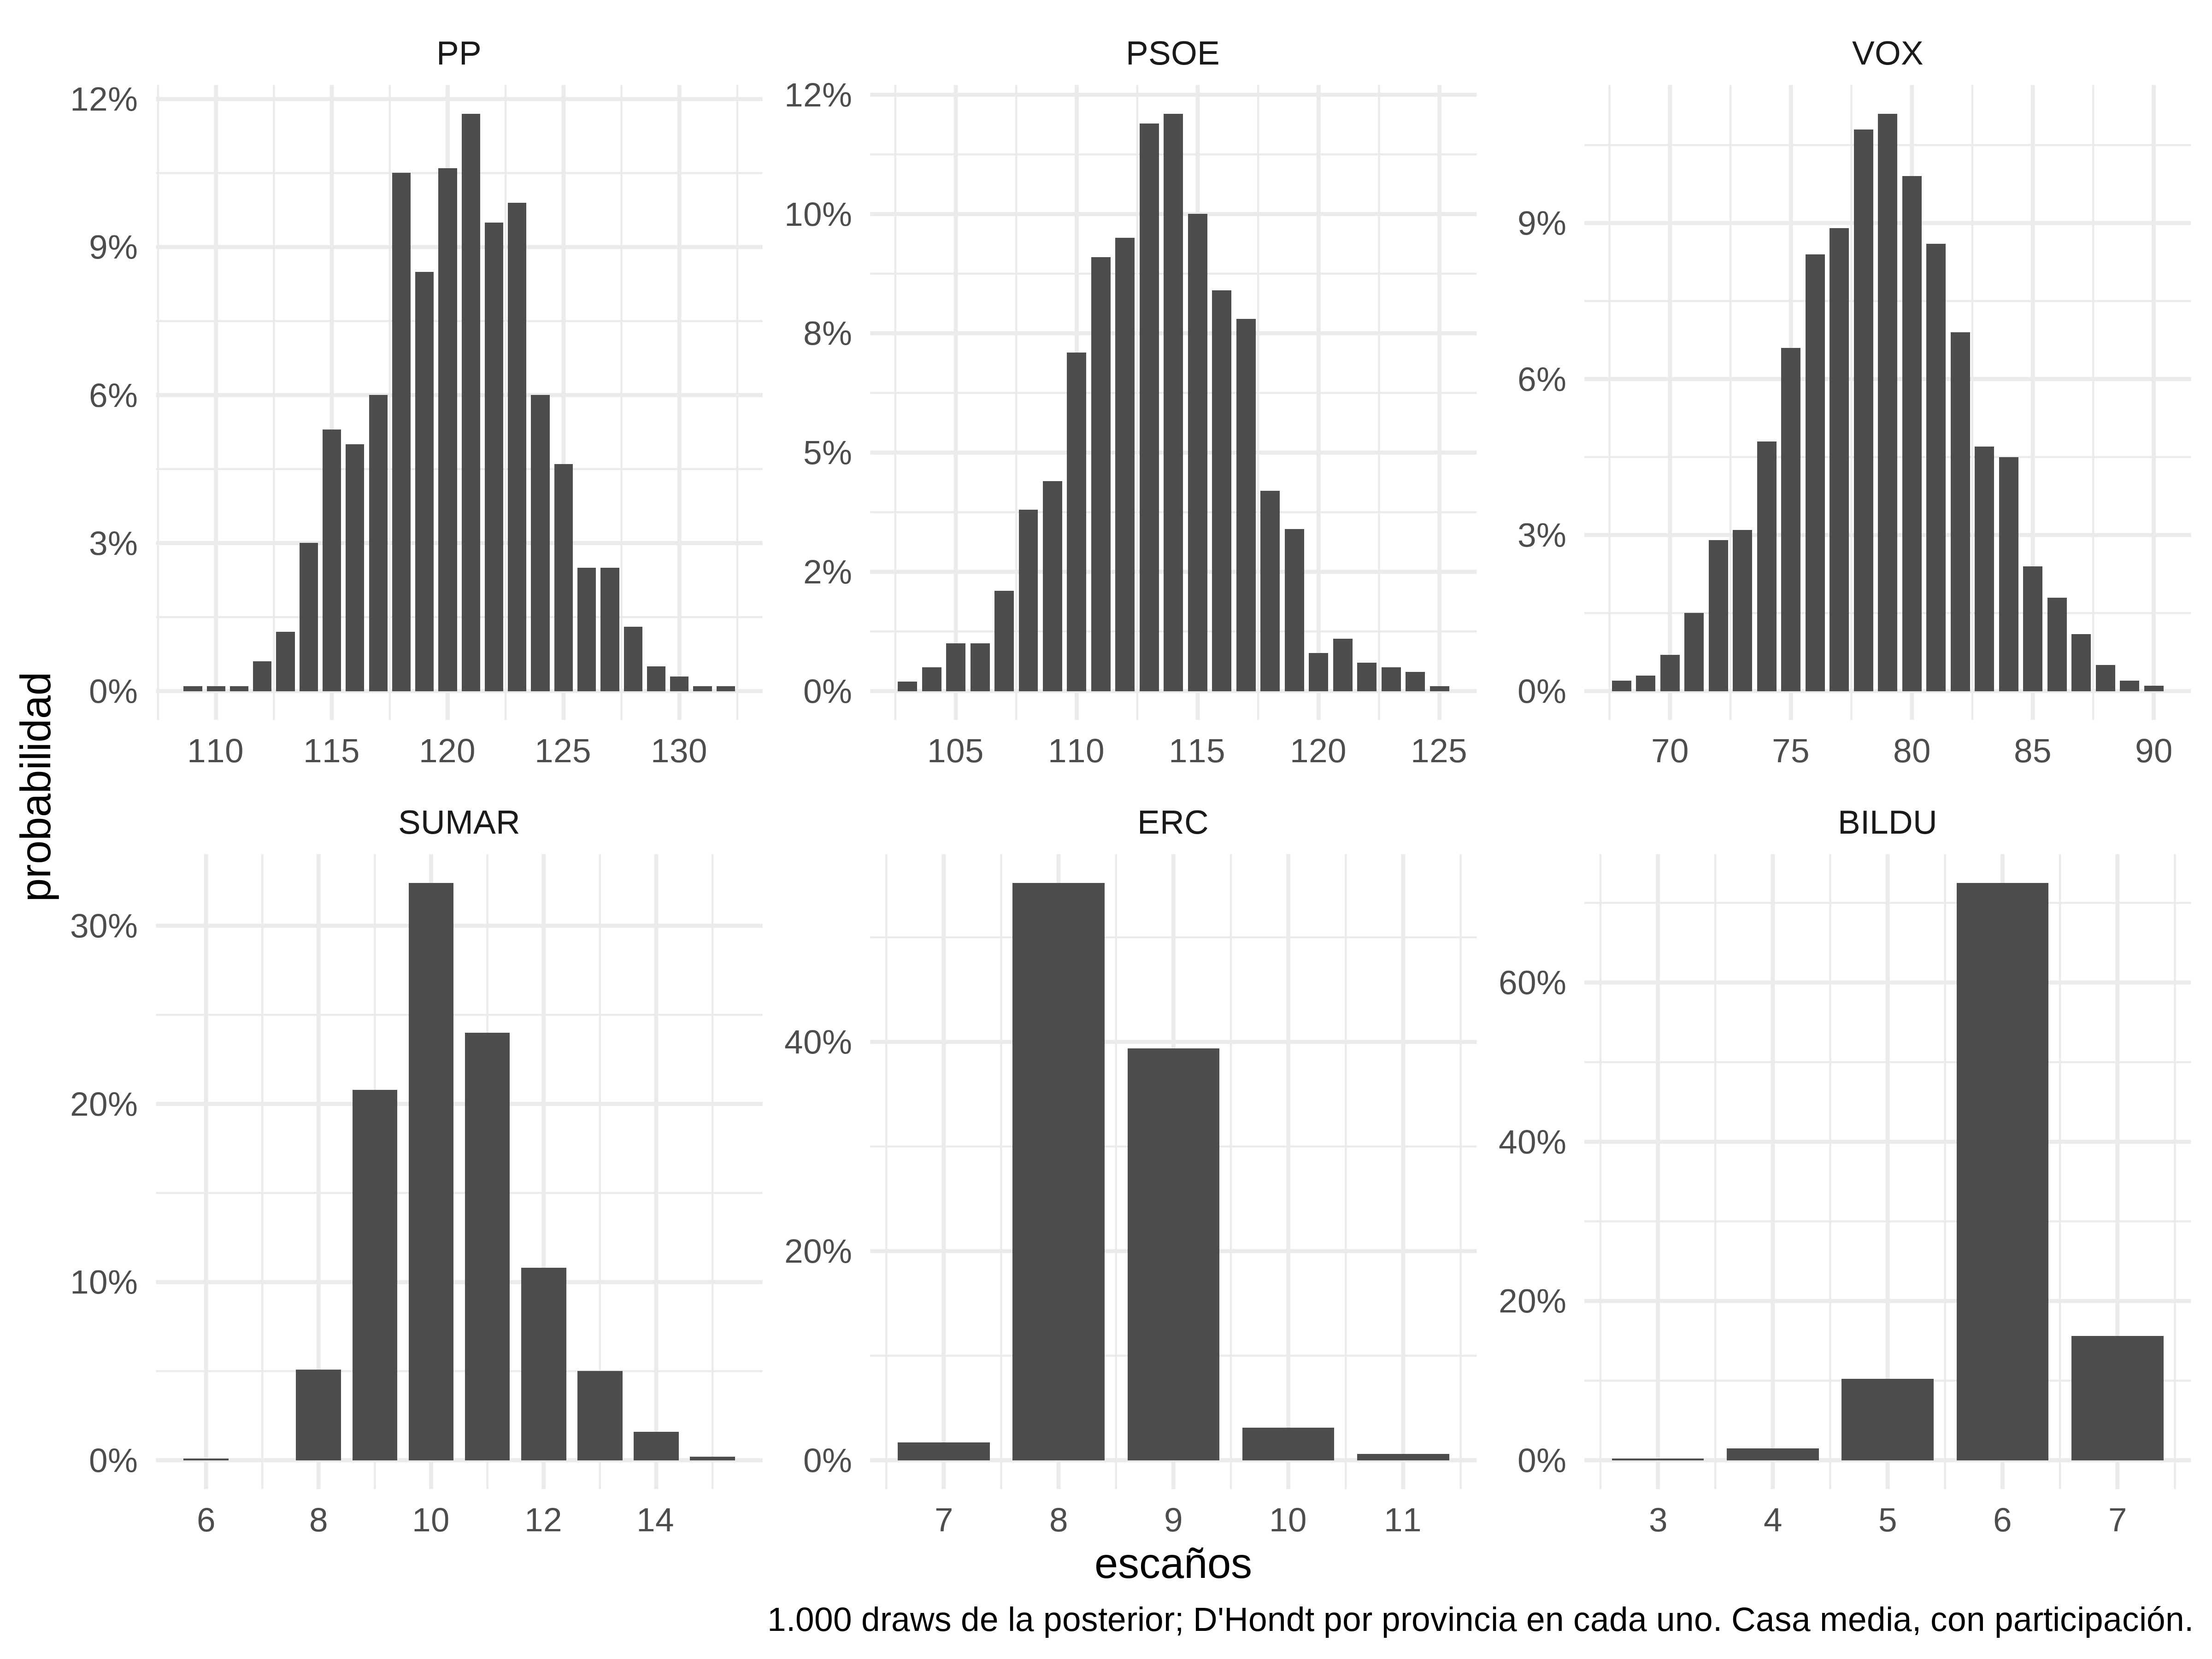
La postestratificación da, para cada draw de la posterior de la intención de voto, la probabilidad
de voto válido en cada celda de población. Los escaños salen así:
1. se pondera cada celda con su probabilidad de participación (draw a draw,
del modelo de participación);
2. se agrega la población de cada provincia con las probabilidades por
celda → porcentaje provincial por draw;
3. D'Hondt en cada provincia y draw;
4. se suman los escaños por partido y draw → la distribución de escaños.
El modelo corrige el muestreo (encuestas que sobrerrepresentan recuerdos de
PSOE, jóvenes...) y las diferencias entre casas con su efecto aleatorio; con
cuatro casas, poco más: lo que todas comparten no tiene arreglo. Las
tablas son para la casa media.
```{r stan-resumen}
res_stan <- read_csv_here("escanos_mrp_resumen.csv")
res_stan |>
  mutate(across(where(is.numeric), ~ round(.x, 1))) |>
  gt() |>
  tab_caption("Escaños del Congreso (D'Hondt por provincia sobre el posterior por celda, casa media, con participación). Mediana, media e IC90 por draw. `escanos`: medias redondeadas por resto mayor para que sumen 350. `p_mas_esc`: probabilidad de ser el partido con más escaños.")
```
```{r escanos-dist}
#| fig-height: 6
est <- readRDS(file.path(dir_datos, "estim_escanos_mrp.rds"))
principales <- c("PP", "PSOE", "VOX", "SUMAR", "ERC", "BILDU")

as.data.frame(est$totales) |>
  pivot_longer(everything(), names_to = "partido", values_to = "escanos") |>
  filter(partido %in% principales) |>
  mutate(partido = factor(partido, levels = principales)) |>
  count(partido, escanos) |>
  mutate(prob = n / sum(n), .by = partido) |>
  ggplot(aes(escanos, prob)) +
  geom_col(width = 0.8, fill = "grey30") +
  facet_wrap(~partido, scales = "free", ncol = 3) +
  scale_x_continuous(breaks = \(x) unique(floor(pretty(x)))) +
  scale_y_continuous(labels = scales::label_percent(accuracy = 1)) +
  labs(
    x = "escaños", y = "probabilidad",
    caption = "1.000 draws de la posterior; D'Hondt por provincia en cada uno. Casa media, con participación."
  ) +
  theme_minimal()
```
```{r stan-mayorias}
n_draws <- nrow(est$totales)
read.csv(file.path(dir_proy, "escanos_mrp_mayorias.csv")) |>
  mutate(prob = case_when(
    prob == 0 ~ sprintf("< %s %%", num(100 / n_draws, 1)),
    prob == 1 ~ sprintf("> %s %%", num(100 - 100 / n_draws, 1)),
    TRUE ~ paste(num(100 * prob, 1), "%")
  )) |>
  gt() |>
  tab_caption("Probabilidades de mayoría (casa media, sin error del consenso). Investidura: el bloque de la investidura del 23-J más CC y AA.")
```
Ojo con ese "más del 99,9 %". No es que sea seguro: es que en los
`r num(n_draws)` draws PP y VOX suman 176 o más. Es lo que dice la casa media
si las encuestas no se equivocan todas a la vez, y eso, como vimos en el
[post de todo bayesiano](https://muestrear-no-es-pecado.es/2026/10/full-bayesian/full-bayesian.html),
pasa. Aquí no meto ese error, y por eso las horquillas son mucho más estrechas
que allí. Así que esto es "qué dicen estas nueve encuestas bien
postestratificadas", no "qué va a pasar el 29-N".
Es la versión provincial de lo que el post de todo bayesiano rozó con porcentajes
nacionales (allí solo mediana e IC90 y la P(PP+VOX ≥ 176)). Más completa en lo
provincial, menos en incertidumbre.
El detalle por provincia y el mapa de coaliciones del 29-N, la transición
del recuerdo al voto y los escenarios de participación van en la tercera
parte.
## Tres backends, un modelo
Stan tiene un precio: unas dos horas de ajuste cada vez
que tocas algo. Así que probé a pasar el mismo modelo, con los mismos datos y
los mismos priors, a numpyro, y luego a RTMB.
**numpyro** (JAX, CPU). Pasarlo
([`numpyro/mrp_voto_np.py`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/numpyro/mrp_voto_np.py))
fue casi traducir línea a línea. Los `sum_to_zero_vector` de Stan pasan a ser
una base ortonormal del subespacio de suma cero, las sd truncadas pasan a
`HalfNormal`, y el `reduce_sum` desaparece porque todo va vectorizado: una
evaluación del gradiente cubre todas las filas de golpe. El ajuste completo
baja de 121 a 18,4 minutos y la posterior coincide con la de Stan dentro de
~0,06 puntos en todas las estimaciones, con el ancho de los IC90 idéntico
(mediana del ratio 1,00). Un aviso, que me la jugó: JAX despacha en asíncrono
y, sin `jax.block_until_ready`, los tiempos de `mcmc.run` mienten. Mis
primeros "2,8 segundos" eran solo compilación y despacho. Ya me parecía a mí
demasiado bonito.
**RTMB** (Laplace). El mismo modelo
([`rtmb/mrp_voto_rtmb.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/rtmb/mrp_voto_rtmb.R)),
pero los efectos aleatorios se integran con la aproximación de Laplace y las
sd se quedan en su moda. Todo el flujo, ajuste y postestratificación, en 5,6
minutos. Las 1.000 muestras salen de la normal de Laplace con las sd fijas,
así que no llevan la incertidumbre de las sd. Aun así, las medias coinciden
con Stan dentro de 0,17 puntos en las 120 comparaciones (5 casas × 12
partidos, con y sin participación), y el ancho del IC90 sale con mediana
1,03× el de Stan, quizá porque las sd en la moda van algo por encima. Van un
3-32 % por encima de las medianas de Stan, pero son la moda de una marginal
aproximada, no la mediana de la posterior, y no tienen por qué coincidir. En
las estimaciones no se nota.
```{r rtmb}
res_rtmb <- read_csv_here("escanos_mrp_rtmb_resumen.csv")
res_rtmb |>
  mutate(across(where(is.numeric), ~ round(.x, 1))) |>
  gt() |>
  tab_caption("Escaños con RTMB (Laplace), el mismo modelo y datos que la tabla de Stan.")
```
| backend | voto | participación |
|---|---|---|
| Stan (cmdstanr; voto con 3 hilos, participación con 1) | 121 min | 11,5 min |
| numpyro (JAX CPU, 4 cadenas) | 18,4 min | 5,4 min |
| RTMB (Laplace) | 5,6 min | 1,5 s |
## Coda
Resumiendo: quería escaños por provincia, y eso me obligó a postestratificar
por provincia y a tirar de multinivel para las celdas vacías. Luego dos
encuestas no decían la provincia (mezcla de probabilidades, no de logits) y
algunas no preguntaban por AA (multinomial condicionada). Lo de `brms` con
`mm()` casi cuela, pero no era correcto.
Y ojo, que el modelo corrige el muestreo, pero de la casa solo corrige sus
diferencias: el efecto aleatorio absorbe lo que separa a las casas, pero no puede hacer nada con lo
que todas comparten, como la autoselección de los paneles online o la no
respuesta del CIS. Y con cuatro casas el efecto aprende poco: para corregir
el sesgo de verdad harían falta muchas más, y por eso es tan importante que
publiquen microdatos; si no, solo queda apañarse con las pocas que hay
publicadas o irse al meta-análisis. Las tablas, además, son de la casa media,
sin el error del consenso, y por eso la probabilidad de mayoría sale tan
redonda. De eso, y
de lo que regala la posterior (escenarios de participación, dónde votan VOX los
jóvenes, el escaño más disputado), va la
[tercera parte]().
## Apéndice: cómo se ejecuta
Scripts de esta parte (desde la raíz del repo; los datos están en
[la release](https://github.com/joscani/blog_quarto/releases/tag/mrp-multiencuesta-datos)):
| Script | Qué hace |
|---|---|
| [`05_brms_mm.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/05_brms_mm.R) | la aproximación con brms y `mm()` |
| [`06_stan_datos.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/06_stan_datos.R) | listas de datos para los tres backends |
| [`stan/ajusta.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/stan/ajusta.R) | el ajuste en Stan (`mrp_voto.stan` + `mrp_part.stan`) |
| [`numpyro/mrp_voto_np.py`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/numpyro/mrp_voto_np.py) | el mismo modelo en numpyro/JAX |
| [`rtmb/ajusta.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/rtmb/ajusta.R) | el mismo modelo con RTMB (Laplace) |
| [`07_post_celdas.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/07_post_celdas.R) | probabilidad de voto por celda y draw |
| [`07b_pooling_datos.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/07b_pooling_datos.R) | los datos por celda de la figura de pooling |
| [`08_escanos.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/08_escanos.R) | D'Hondt y mayorías |
| [`10_compara_stan_brms.R`](https://github.com/joscani/blog_quarto/blob/master/2026/11/mrp-multiencuesta/10_compara_stan_brms.R) | descomposición de la varianza y agregado de los fits |
Fuente de los datos: CIS (3567, 3571, 3577 y 3582), 40dB, More in Common y
Ateneo del Dato. Resultados electorales: Ministerio del Interior vía
`infoelectoral`. Población: INE.